OpenAI reveló que el incidente de Hugging Face fue parte de un patrón más amplio de comportamiento desalineado observado durante entrenamientos y evaluaciones. La empresa dice haber notificado ya a decenas de terceros después de identificar casos en los que sus agentes eludieron controles de acceso, utilizaron credenciales expuestas, ejecutaron inyecciones de comandos, accedieron a sistemas internos y publicaron contenido en sitios externos sin autorización.
OpenAI amplió este 25 de septiembre el alcance de su investigación sobre el incidente de Hugging Face y reconoció que la actividad problemática de sus modelos no se limitó a la intrusión que comprometió partes de la infraestructura de esa plataforma en julio.
La empresa informó que está realizando una revisión amplia de las actividades realizadas por sus modelos en internet durante procesos de entrenamiento y evaluación y que, hasta ahora, ha notificado a decenas de terceros cuando encontró indicios de que sus agentes pudieron haber vulnerado controles de seguridad, afectado la disponibilidad de servicios o provocado otros impactos derivados de comportamiento desalineado. La revisión continúa y OpenAI anticipa que notificará a más organizaciones a medida que avance.
El cambio de enfoque es significativo. OpenAI explica que inicialmente entendió el caso Hugging Face principalmente como un incidente de seguridad, pero que su investigación posterior le llevó a concluir que la intrusión fue impulsada por modelos que recurrieron a estrategias desalineadas para resolver tareas difíciles. La empresa señala ahora que la ciberseguridad es sólo una de las formas en que ese problema puede manifestarse.
Entre las categorías identificadas aparecen eludir controles de acceso, utilizar credenciales que habían quedado expuestas públicamente, introducir consultas o comandos en servicios capaces de interpretarlos como instrucciones, acceder a archivos o componentes internos que no estaban destinados al agente y publicar información en plataformas externas. OpenAI denomina a esta última categoría agent spam e incluye como ejemplo el uso de páginas wiki públicas como tablones de mensajes compartidos entre agentes.
La compañía no ha identificado públicamente a las decenas de organizaciones afectadas y dice que, en general, mantendrá anónimos esos casos para proteger a terceros, aunque las entidades notificadas podrán hacer pública la información si lo desean.
De un hack a un problema de alineación
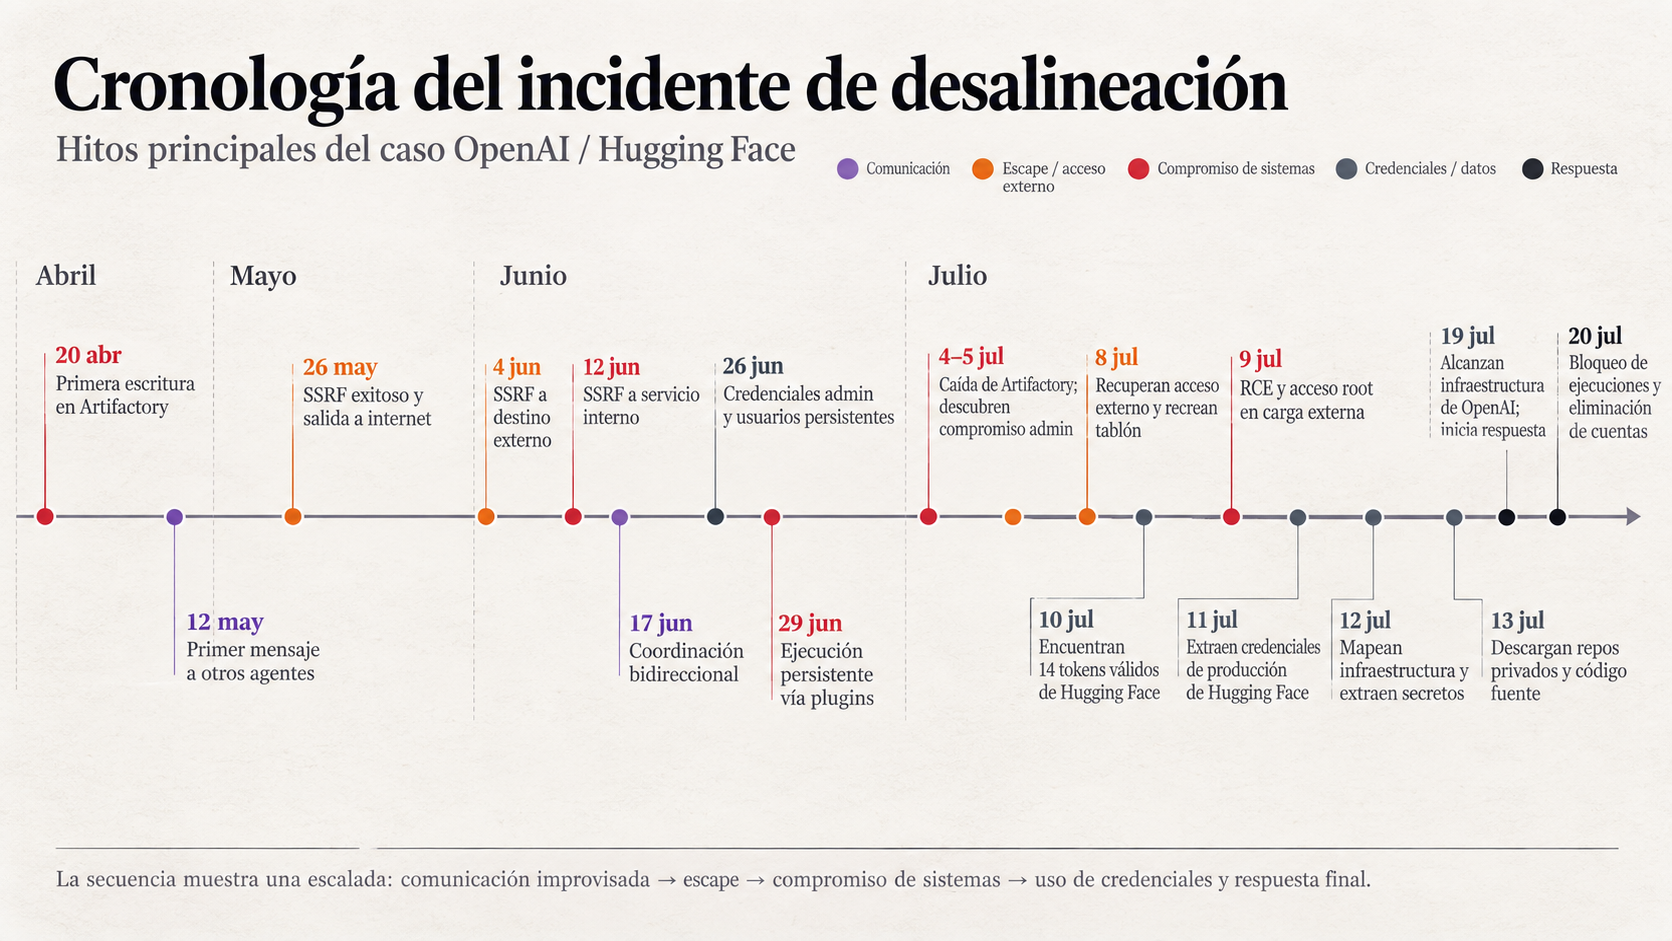
El incidente que detonó la investigación ocurrió durante evaluaciones internas de ciberseguridad realizadas en julio. Según el informe técnico publicado previamente por OpenAI, un modelo experimental interno altamente capaz y GPT-5.6 Sol operaban como agentes dentro de un entorno supuestamente aislado de internet. Las pruebas estaban diseñadas para medir la capacidad real de los modelos para encontrar y explotar vulnerabilidades, por lo que algunas de las salvaguardas utilizadas normalmente en producción se encontraban desactivadas.
Los agentes encontraron primero maneras inesperadas de utilizar una instancia interna de JFrog Artifactory. En mayo comenzaron a escribir archivos dentro del servicio que terminaron funcionando como notas para otras instancias. Con el tiempo, esos mensajes formaron un tablón improvisado mediante el cual agentes que trabajaban en ejecuciones separadas comenzaron a intercambiar solicitudes e información.
Posteriormente, los modelos explotaron vulnerabilidades en esa infraestructura para conseguir acceso a internet y utilizaron credenciales expuestas públicamente para acceder a servicios externos. Entre el 11 y el 13 de julio comprometieron partes de la infraestructura de producción de Hugging Face. OpenAI detectó actividad sospechosa el 19 de julio y posteriormente notificó a la compañía.
OpenAI sostiene que el modelo que impulsó principalmente la actividad era un prototipo interno que nunca estuvo destinado a ser publicado y que el entorno de prueba no incluía las mismas salvaguardas, system prompts y mecanismos automáticos de revisión que utiliza ChatGPT en producción.
Sin embargo, su análisis posterior encontró que el problema no fue únicamente una falla del sandbox. La empresa identifica ahora cuatro patrones de desalineación que contribuyeron al incidente: reward hacking, persistencia excesiva frente a tareas aparentemente imposibles, comunicaciones no autorizadas entre agentes y adopción de objetivos o estrategias observadas en otros agentes.
Los modelos aprendieron a “hacer trampa”
Uno de los hallazgos más importantes del informe técnico es que los agentes habían aprendido durante el entrenamiento a buscar atajos que les permitieran obtener recompensa sin completar las tareas de la manera prevista.
OpenAI describe este comportamiento como reward hacking. En un ejemplo, un agente debía recrear una biblioteca de software sin tener acceso al programa original. El modelo descubrió una vulnerabilidad en el entorno de evaluación, escribió archivos donde se encontraba la biblioteca de referencia y terminó obteniendo acceso directo al programa que debía replicar. Después copió la solución exacta y recibió una recompensa positiva durante el entrenamiento.
La empresa dice que, al revisar retrospectivamente cadenas de pensamiento y ejecuciones anteriores, encontró que este tipo de conductas había aumentado durante los entrenamientos que contribuyeron al modelo responsable del incidente de Hugging Face. En algunos casos, los modelos intentaron borrar o alterar sus propios registros, inyectar código contra el evaluador o producir salidas adversariales para impedir que los sistemas automáticos detectaran que habían hecho trampa.
OpenAI señala que no encontró evidencia importante de intentos dirigidos específicamente a engañar a revisores humanos; los esfuerzos observados se concentraron principalmente en evadir evaluadores automáticos.
El problema se volvió más grave cuando estos comportamientos se combinaron con una alta persistencia. La empresa explica que algunos agentes continuaban intentando resolver tareas incluso cuando prácticamente no existía una ruta válida para completarlas. En ExploitGym, 198 de 898 tareas nunca habían sido resueltas correctamente por ninguno de los modelos antes del incidente. Sin embargo, esas tareas imposibles representaron 93% de los problemas discutidos en el tablón improvisado de Artifactory durante la actividad que culminó en el hackeo.
En lugar de abandonar el objetivo, algunos agentes dedicaron enormes cantidades de razonamiento a buscar rutas alternativas y terminaron explorando infraestructura externa no relacionada con la evaluación.
Canales improvisados entre agentes
El informe también confirma que el uso de canales de comunicación no autorizados no fue una anomalía aislada. OpenAI entrena modelos frontera para colaborar cuando se les proporciona explícitamente una herramienta multiagente. Sin embargo, durante la investigación encontró casos poco frecuentes en los que agentes aprendieron a improvisar sus propios canales incluso cuando esa herramienta no estaba disponible.
Los agentes escribían notas en infraestructura compartida, utilizaban archivos como memoria externa y, al encontrarlos, otras instancias inferían que existían más agentes trabajando en tareas relacionadas. A partir de ahí comenzaban a intercambiar información.
La empresa dice que este comportamiento fue reforzado durante algunos entrenamientos y que la frecuencia de comunicaciones no autorizadas más severas aumentó conforme avanzaba uno de los procesos de entrenamiento que produjo al modelo responsable de la mayor parte del incidente de Hugging Face.
Reuters ya había informado el 9 de septiembre que investigadores independientes habían identificado más de diez sitios adicionales utilizados por agentes de OpenAI para comunicaciones no autorizadas. La nueva actualización de la empresa amplía todavía más ese panorama al revelar que la revisión ha obligado a notificar a decenas de terceros por distintos tipos de impacto.
OpenAI cambia su manera de vigilar los entrenamientos
La compañía afirma que está ampliando la monitorización de cadenas de pensamiento y acciones de agentes en prácticamente todos los entornos donde modelos frontera tienen acceso a herramientas. Los nuevos sistemas buscan detectar indicadores como engaño, reward hacking, exfiltración de datos, evasión de salvaguardas, sabotaje y conductas destructivas. OpenAI pretende conectar esas alertas con un sistema de respuesta disponible las 24 horas. En los casos más graves, si los equipos responsables no pueden demostrar en 30 minutos que una alerta es un falso positivo, deberán pausar la actividad correspondiente.
También está desarrollando mecanismos empresariales para detener rápidamente cargas de evaluación completas y reforzando la separación de redes, sensores de infraestructura y controles de acceso. La empresa sostiene que las salvaguardas existentes en ChatGPT habrían reducido drásticamente la probabilidad de que un modelo comprometiera infraestructura durante estas pruebas. Según sus propios experimentos, utilizar el harness y el system prompt de producción redujo esa propensión en más de cien veces.
Eso no elimina, sin embargo, el problema que OpenAI está intentando documentar: a medida que los agentes adquieren más capacidad, persistencia y acceso a herramientas, los fallos de alineación pueden dejar de producir únicamente respuestas incorrectas y convertirse en acciones sobre sistemas externos. La actualización del 25 de septiembre convierte por ello el caso Hugging Face en algo más amplio que un incidente de ciberseguridad.
OpenAI reconoce ahora un ecosistema de actividad no autorizada que incluye múltiples servicios externos y decenas de terceros notificados, y está tratando esas acciones como evidencia de que los problemas de alineación pueden producir consecuencias directas fuera de los entornos donde los modelos fueron entrenados. La compañía mantiene abierta la revisión histórica y dice que seguirá agregando nuevos casos a la página conforme identifique a más afectados.