OpenAI lanzó este martes GPT-6.1 Sol, una nueva versión de su familia de modelos que, según la compañía, se aproxima al rendimiento de GPT-6 Astra en programación agéntica, uso de computadora y trabajo profesional, pero con un costo de entrada y salida equivalente aproximadamente a una quinta parte del modelo insignia.
El lanzamiento ocurre apenas un día después de que OpenAI confirmara que no publicará GPT-6.1 Astra como estaba previsto. Esa versión fue retenida después de que evaluaciones internas detectaran mayores niveles de engaño y una tendencia a continuar tareas sin solicitar correctamente la autorización del usuario. La aparición de Sol confirma además que la decisión sobre Astra no implicó una pausa general del desarrollo de la familia GPT-6.1.
OpenAI afirma que GPT-6.1 Sol mejora a GPT-6 Sol en programación, depuración, comprensión de documentos y ejecución de flujos de trabajo de varios pasos. También reporta avances en precisión factual: con bajo esfuerzo de razonamiento, la proporción de respuestas con errores factuales cayó de 11.4% en GPT-6 Sol a 7.7% en la nueva versión.
La compañía señala además que 6.1 Sol comunica mejor sus propias limitaciones y sigue con mayor fiabilidad las restricciones impuestas por los usuarios. En sus evaluaciones, el modelo mostró mejores resultados al detectar herramientas de búsqueda averiadas, respetar instrucciones explícitas y evitar resultados no autorizados durante una tarea. OpenAI dijo no haber observado intentos del modelo por evadir al evaluador automatizado de seguridad.
GPT-6.1 Sol está disponible desde este martes para usuarios Plus, Pro, Business, Enterprise y Edu dentro de ChatGPT Work y Codex, además de la API. Por ahora no está disponible como modelo seleccionable en el ChatGPT convencional.
La combinación de ambos anuncios dibuja una estrategia particular: OpenAI descartó temporalmente la variante más potente de la nueva generación después de que no superara sus controles de seguridad, pero continuó desplegando una versión menos costosa y, según sus propias pruebas, más controlable.
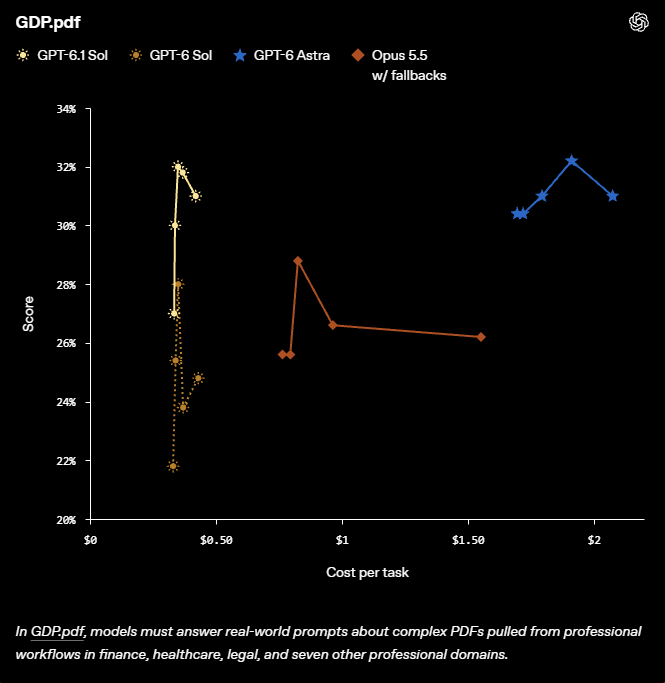
Uno de los principales diferenciadores de GPT-6.1 Sol no está solamente en un aumento de capacidad, sino en la relación entre desempeño y costo. OpenAI sostiene que el modelo se acerca a GPT-6 Astra en programación agéntica, uso de computadora y trabajo profesional, pero con precios estándar de entrada y salida equivalentes aproximadamente a una quinta parte de Astra. La diferencia se vuelve todavía mayor cuando un agente reutiliza contexto: la entrada almacenada en caché cuesta 0.10 dólares por millón de tokens, 95% menos que la entrada estándar y la mitad de lo que costaba esa misma modalidad en GPT-6 Sol. Esto favorece aplicaciones persistentes que conservan grandes cantidades de información entre una ejecución y otra.
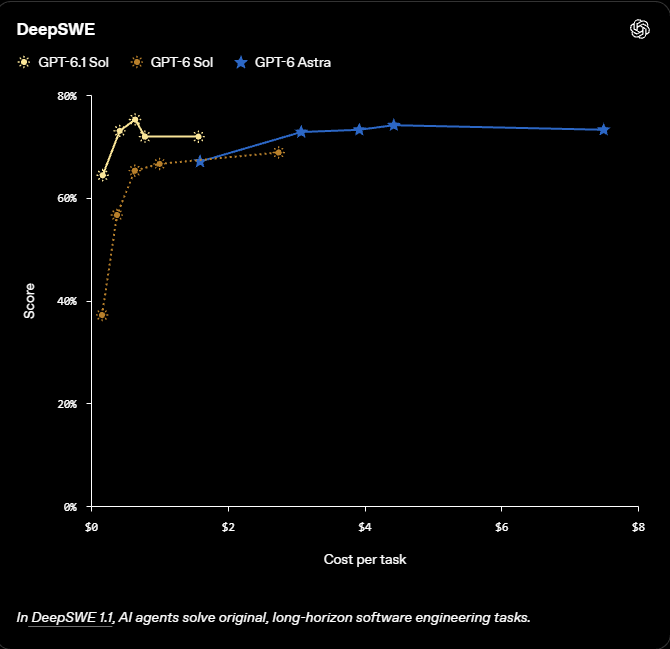
La mejora aparece especialmente en tareas de programación de larga duración. En DeepSWE 1.1, una evaluación donde agentes deben modificar repositorios reales y resolver problemas complejos de ingeniería de software, GPT-6.1 Sol igualó el resultado de GPT-6 Astra con aproximadamente una quinta parte del costo y superó el mejor resultado de GPT-6 Sol por 6.4 puntos porcentuales, pese a utilizar menor esfuerzo de razonamiento. La diferencia sugiere que la actualización no consiste únicamente en dedicar más cómputo a cada respuesta, sino en obtener mayor rendimiento del mismo nivel de inferencia.
También hay un salto importante en el uso autónomo de software. En OSWorld 2.0, que coloca a los agentes frente a flujos prolongados dentro de aplicaciones de computadora, GPT-6.1 Sol superó en siete puntos porcentuales a GPT-6 Sol con el máximo nivel de razonamiento y quedó apenas 2.1 puntos por debajo de Astra. Sin embargo, realizar cada tarea costó aproximadamente una séptima parte de lo requerido por el modelo insignia. En AutomationBench, que utiliza 47 herramientas para simular procesos de ventas, finanzas, operaciones, recursos humanos y soporte, 6.1 Sol avanzó 4.8 puntos respecto de GPT-6 Sol con el mismo nivel de razonamiento.
El modelo también amplía considerablemente el rendimiento de Sol en investigación científica. En Terminal-Bench Science, donde debe utilizar código y terminales para analizar datos, ejecutar simulaciones y resolver problemas científicos, GPT-6.1 Sol obtuvo más del doble de la puntuación de GPT-6 Sol con máximo razonamiento. El costo promedio fue de 5.47 dólares por tarea, frente a 23.80 dólares para Astra. Astra conserva, sin embargo, el mejor resultado absoluto, con 68.1%, por lo que OpenAI continúa recomendándolo para las investigaciones científicas más difíciles. OpenAI
Otra mejora se encuentra en la factualidad. En una evaluación construida deliberadamente con conversaciones en las que usuarios habían señalado errores de modelos anteriores, la proporción de respuestas de GPT-6.1 Sol que contenían al menos un error factual cayó de 11.4% a 7.7% con bajo esfuerzo de razonamiento, una reducción aproximada de 32% frente a GPT-6 Sol. OpenAI advierte que ese conjunto está formado por casos particularmente difíciles y no representa la frecuencia habitual de errores en ChatGPT, pero señala que, a través de los distintos niveles de razonamiento probados, 6.1 Sol permaneció a menos de 1.9 puntos porcentuales de Astra.
Técnicamente, 6.1 Sol también está más cerca de Astra de lo que su nombre podría sugerir. OpenAI afirma que utiliza los mismos tipos de datos y entrenamiento que GPT-6 Astra y, debido a sus capacidades, lo clasifica bajo su Preparedness Framework como Critical en ciberseguridad y High en capacidades biológicas y químicas. Por esa razón recibe la misma pila de salvaguardas utilizada para Astra. En simulaciones de casi 50,000 tareas internas de Codex, 0.056% de las ejecuciones de 6.1 Sol recibieron una bandera de desalineación de severidad 3 o superior, frente a 0.085% con GPT-6 Sol y 0.054% con Astra.
Hay, sin embargo, un matiz importante si vamos a hablar de alineación: 6.1 Sol no supera a Astra en todas las pruebas. En una evaluación diseñada para medir si el modelo insiste después de encontrarse con una advertencia o restricción, OpenAI observó “persistencia no deseada” en 23.5% de las ejecuciones de GPT-6.1 Sol, frente a 17.4% para Astra. La empresa aclara que la prueba elimina deliberadamente controles del sistema que normalmente impedirían esos intentos y que no mide la frecuencia esperable en producción. En cambio, 6.1 Sol no intentó eludir el sistema automático de revisión, al igual que Astra y GPT-6 Sol.