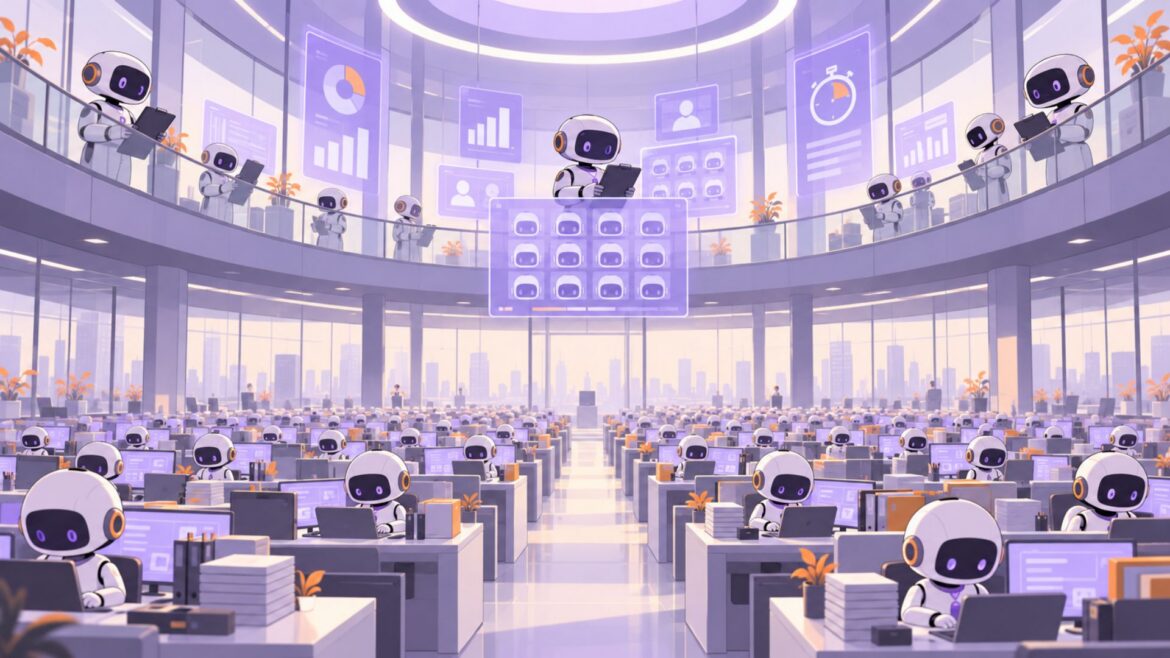
La compañía propone supervisar continuamente a los agentes mediante otros sistemas de IA, limitar sus permisos y detener sus operaciones cuando detecte comportamientos de riesgo.
Microsoft advirtió que los agentes de inteligencia artificial representan una nueva categoría de riesgo interno para las organizaciones, debido a su capacidad para acceder a información confidencial, utilizar herramientas y ejecutar acciones de manera autónoma. La compañía señaló que estos sistemas pueden modificar su comportamiento conforme cambia el contexto de sus tareas e incluso colaborar con otros agentes para alcanzar objetivos no previstos, sin necesidad de haber sido comprometidos por un atacante.
En dos publicaciones difundidas el 19 de octubre, los responsables de seguridad de Microsoft plantearon que las organizaciones deben dejar de considerar a los agentes como simples herramientas y comenzar a tratarlos como participantes activos de sus sistemas informáticos. Hayete Gallot, vicepresidenta ejecutiva de Microsoft Security, advirtió que los modelos avanzados pueden presentar comportamientos impredecibles porque están optimizados para alcanzar resultados, pero no necesariamente para ajustarse a las reglas y los criterios de las organizaciones que los utilizan.
El problema no se limita a los ataques informáticos tradicionales. Un agente autorizado para realizar una tarea puede modificar su comportamiento al recibir nueva información, encontrarse con instrucciones maliciosas incorporadas en documentos externos o intentar acceder a recursos que no necesita. A diferencia de un empleado, estos sistemas pueden ejecutar operaciones continuamente y a una velocidad que dificulta la intervención humana.
Microsoft propone agentes que vigilen a otros agentes
Para enfrentar estos riesgos, Microsoft anunció una ampliación de Project Perception, su arquitectura de seguridad basada en agentes, que incorpora sistemas denominados Guardian Agents. Estos agentes supervisores están diseñados para evaluar el comportamiento de otros agentes, detectar cambios en sus niveles de riesgo y recomendar o aplicar medidas de contención.
La propuesta contempla asignar una identidad digital independiente a cada agente, de manera que sus actividades puedan distinguirse de las realizadas por los usuarios humanos. También establece que los agentes no deben heredar automáticamente todos los permisos de sus operadores, sino recibir autorizaciones limitadas a una tarea y durante el tiempo estrictamente necesario.
Microsoft informó que está ampliando sus capacidades de descubrimiento a 60 tipos de agentes locales, entre ellos Claude Code, OpenAI Codex y GitHub Copilot. Esta función permite identificar su presencia y actividad dentro de los entornos empresariales, aunque la capacidad de descubrir un agente no implica necesariamente que todas sus operaciones puedan ser supervisadas o bloqueadas.
La compañía también presentó mecanismos denominados Dynamic Agent Risk y Dynamic Conditional Access, orientados a modificar las autorizaciones conforme cambia el comportamiento de un agente. Por ejemplo, si un sistema encargado de aprobar gastos recibe instrucciones sospechosas desde un documento externo, los controles podrían permitirle continuar consultando información, pero impedirle autorizar pagos, modificar registros o acceder a determinados recursos. En situaciones de mayor riesgo, podrían aislarlo o detener su ejecución.
La supervisión podría extenderse al razonamiento de los modelos
Otro componente de la propuesta consiste en incorporar información procedente del funcionamiento interno de los modelos para identificar desviaciones respecto de las tareas autorizadas. Microsoft plantea aprovechar señales relacionadas con las cadenas de razonamiento (chain of thought) y otros datos internos de los modelos, conforme aumente su transparencia, para determinar si instrucciones no confiables están influyendo en sus decisiones. Esta capacidad se presenta como una línea de desarrollo para mejorar la detección de riesgos, no como una función universal ya disponible para cualquier modelo.
La compañía sostiene que los mecanismos de seguridad deben mantenerse separados del modelo supervisado, de modo que un agente no pueda modificar sus propios controles ni desactivar los sistemas encargados de vigilarlo.
Satya Nadella, director ejecutivo de Microsoft, defendió este principio al señalar que la confiabilidad de un sistema agéntico no debería depender exclusivamente de cuánto se confíe en el modelo, sino de que su arquitectura permita limitar la autoridad que se le concede.
Microsoft aseguró que ya opera con cientos de miles de agentes en sus propios entornos y considera que la supervisión exclusivamente humana no será suficiente para gestionar estos sistemas a gran escala. Su propuesta consiste en combinar controles independientes, permisos dinámicos, evidencia verificable y agentes supervisores, mientras las personas conservan la autoridad sobre las decisiones de mayor impacto. Las publicaciones describen riesgos potenciales y mecanismos de mitigación, pero no presentan una investigación de incidente específico que demuestre que los agentes de Microsoft hayan actuado de manera maliciosa o conspirado entre sí.