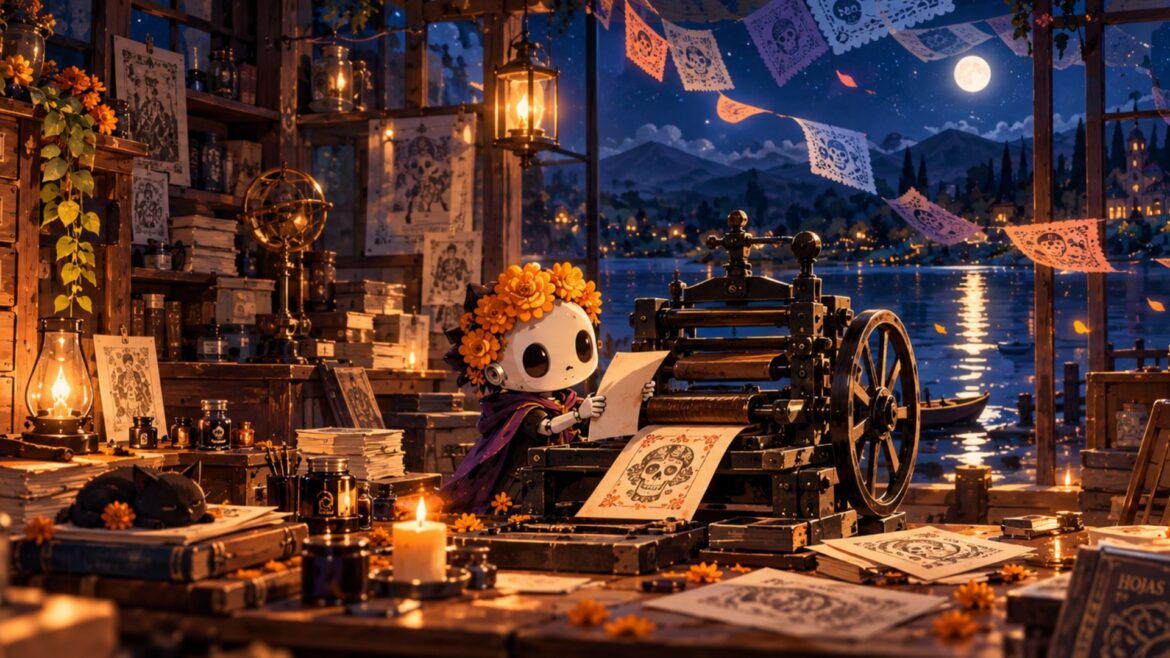
Con apenas 940 mil parámetros, este modelo de lenguaje desarrollado desde cero forma parte de un experimento que une inteligencia artificial, literatura mexicana y la tradición de las calaveritas del Día de Muertos.
Se llama Calaca, y su especialidad es producir pequeñas frases que imprime en hojas volantes, como si salieran de un taller editorial de principios del siglo XX. Detrás de ese universo ilustrado hay un experimento real de inteligencia artificial desarrollado por EstadoRed. Calaca es un modelo de lenguaje construido y entrenado desde cero en español, con aproximadamente 940 mil parámetros, una dimensión muy pequeña frente a los grandes sistemas de IA que conocemos actualmente.
El proyecto nació con motivo del Día de Muertos de 2026 y de una pregunta que nos llevó a explorar tanto la tecnología como la literatura: ¿qué podemos enseñarle a un modelo de lenguaje diminuto a partir de una tradición cultural mexicana?
Un viaje a las calaveritas de hace más de cien años
La historia comenzó con la búsqueda y recopilación de calaveritas literarias mexicanas de principios del siglo XX, conservadas en publicaciones históricas y actualmente de dominio público. Al reunir este acervo descubrimos mucho más que versos dedicados a la muerte. Las calaveritas también son pequeños retratos de la sociedad mexicana de su época: hablan de profesiones, personajes públicos, costumbres, preocupaciones cotidianas y acontecimientos que sus autores abordaban mediante el humor y la sátira.
La investigación nos permitió acercarnos a distintas formas de expresión popular y observar cómo los mexicanos han utilizado la figura de la Muerte para hablar, con irreverencia e imaginación, de la vida misma. Conservamos la procedencia de los materiales históricos y sus particularidades lingüísticas, desde expresiones populares hasta formas de escritura propias de su tiempo. Después ampliamos el trabajo con materiales complementarios y diferentes estrategias de entrenamiento, procurando mantener la revisión humana y la trazabilidad de los textos. Así, lo que comenzó como una exploración tecnológica también se convirtió en una experiencia de investigación cultural.
Una inteligencia artificial pequeña, con un diseño propio
Para construir a Calaca utilizamos una arquitectura conocida como Transformer, la tecnología que también está presente en muchos de los grandes modelos de lenguaje actuales, pero a una escala considerablemente menor. En lugar de partir de un modelo ya entrenado, comenzamos con una red neuronal cuyos parámetros se inicializaron desde cero. Nuestro objetivo era estudiar cómo podía adquirir regularidades del español y aprovecharlas para producir expresiones breves.
El tamaño del modelo planteó un desafío interesante: encontrar una forma de transformar sus capacidades lingüísticas en resultados que las personas pudieran leer y disfrutar. Para conseguirlo desarrollamos un sistema experimental propio que combina las preferencias lingüísticas aprendidas por Calaca con reglas que ayudan a organizar las frases. De esta manera, el modelo participa en la selección de las palabras dentro de una estructura diseñada para producir expresiones breves y comprensibles.
El resultado son pequeñas frases independientes que pueden evocar recuerdos, personajes, situaciones cotidianas o imágenes relacionadas con el universo cultural del proyecto. Algunas resultan poéticas, otras son inesperadas y algunas tienen ese humor involuntario que las vuelve especialmente divertidas.
Un laboratorio que seguirá creciendo
Calaca no fue concebida como una alternativa a los grandes asistentes de inteligencia artificial. Es un proyecto experimental para investigar qué pueden hacer los modelos pequeños cuando se combinan entrenamiento especializado, conocimiento lingüístico y soluciones de diseño desarrolladas para una tarea concreta.
Durante su construcción exploramos distintas formas de entrenamiento, representación del lenguaje y generación de texto. Cada etapa nos permitió comprender mejor las capacidades de una arquitectura pequeña y encontrar nuevas preguntas para continuar investigando.
El proyecto permanece abierto. Queremos seguir estudiando cómo aprenden estos sistemas, qué posibilidades ofrecen las arquitecturas de menor tamaño y cómo pueden vincularse con acervos culturales y experiencias de divulgación. Por ahora, Calaquita tiene una tarea mucho más sencilla: trabajar en su pequeña imprenta y compartir sus palabras con quienes decidan visitarla.
El lado técnico
Calaca es un modelo de lenguaje pequeño desarrollado desde cero para estudiar hasta dónde puede llegar un Transformer especializado en una tradición literaria concreta: la calaverita mexicana. El proyecto no parte de pesos preentrenados ni pretende construir un modelo generalista. Su corpus, entrenamiento, evaluaciones y transformaciones se han mantenido con trazabilidad experimental y separación explícita entre materiales históricos, datos sintéticos y resultados generados.
La versión que terminó convirtiéndose en el núcleo del sistema, C150+100, es un Transformer decoder-only de 940,800 parámetros, con cuatro bloques Transformer, dimensión interna de 128, cuatro cabezas de atención, MLP de 512 unidades, contexto de 128 tokens y vocabulario BPE de 1,024 unidades. Durante los experimentos finales el checkpoint se mantuvo congelado: las mejoras del sistema no procedieron de seguir modificando sus pesos, sino de cambiar la forma en que se le permitía generar.
El problema que apareció durante el entrenamiento
El paso de representación carácter por carácter a BPE mejoró especialmente la forma superficial del lenguaje y la capacidad de memorización. Sin embargo, esas mejoras no resolvieron el problema central: el modelo continuaba teniendo dificultades para mantener de manera fiable una relación entre participantes, acción, contexto y cierre durante una oración completa.
Los experimentos posteriores mostraron repetidamente una separación entre tener información representada y utilizarla correctamente durante la generación. En algunas tareas controladas fue posible recuperar relaciones contextuales con alta precisión o intervenir sobre la salida para mejorar decisiones concretas. Pero esas mejoras locales no se transformaban automáticamente en generación libre robusta.
El diagnóstico práctico terminó siendo más sencillo: Calaca podía encontrar asociaciones y preferencias lingüísticas interesantes, pero no conseguía organizar de manera estable todos los elementos necesarios para convertirlas en una frase útil.
Integramos un arnés para solucionar los problemas de estructura. Al restringir cuidadosamente el dominio donde esas preferencias pueden actuar, el sistema consigue convertir una capacidad demasiado inestable para utilizarse en generación libre en una pequeña función generativa reproducible.
El resultado puede resumirse así:
Calaca aprendió pequeñas preferencias del lenguaje que, aisladas, eran demasiado inestables para convertirse en producto. El arnés no le enseñó retrospectivamente a escribir: construyó un espacio donde esa capacidad pequeña podía utilizarse sin atribuirle capacidades que el modelo no había demostrado.
Visita el micrositio en:
Calaca es un proyecto experimental de investigación y desarrollo de EstadoRed, realizado con motivo del Día de Muertos de 2026.