Publicado en Nature, structRFM fue entrenado con 21 millones de pares de secuencias y estructuras de ARN. Sus creadores reportan mejoras en predicción molecular y resultados comparables a AlphaFold 3 en determinadas pruebas.
Un equipo de investigadores de instituciones científicas chinas desarrolló structRFM, un modelo fundacional de inteligencia artificial capaz de analizar tanto las secuencias del ácido ribonucleico (ARN) como las relaciones estructurales que determinan su plegamiento. El sistema fue entrenado con 21 millones de pares de secuencia y estructura, y sus resultados fueron publicados el 4 de noviembre de 2026 en la revista científica Nature.
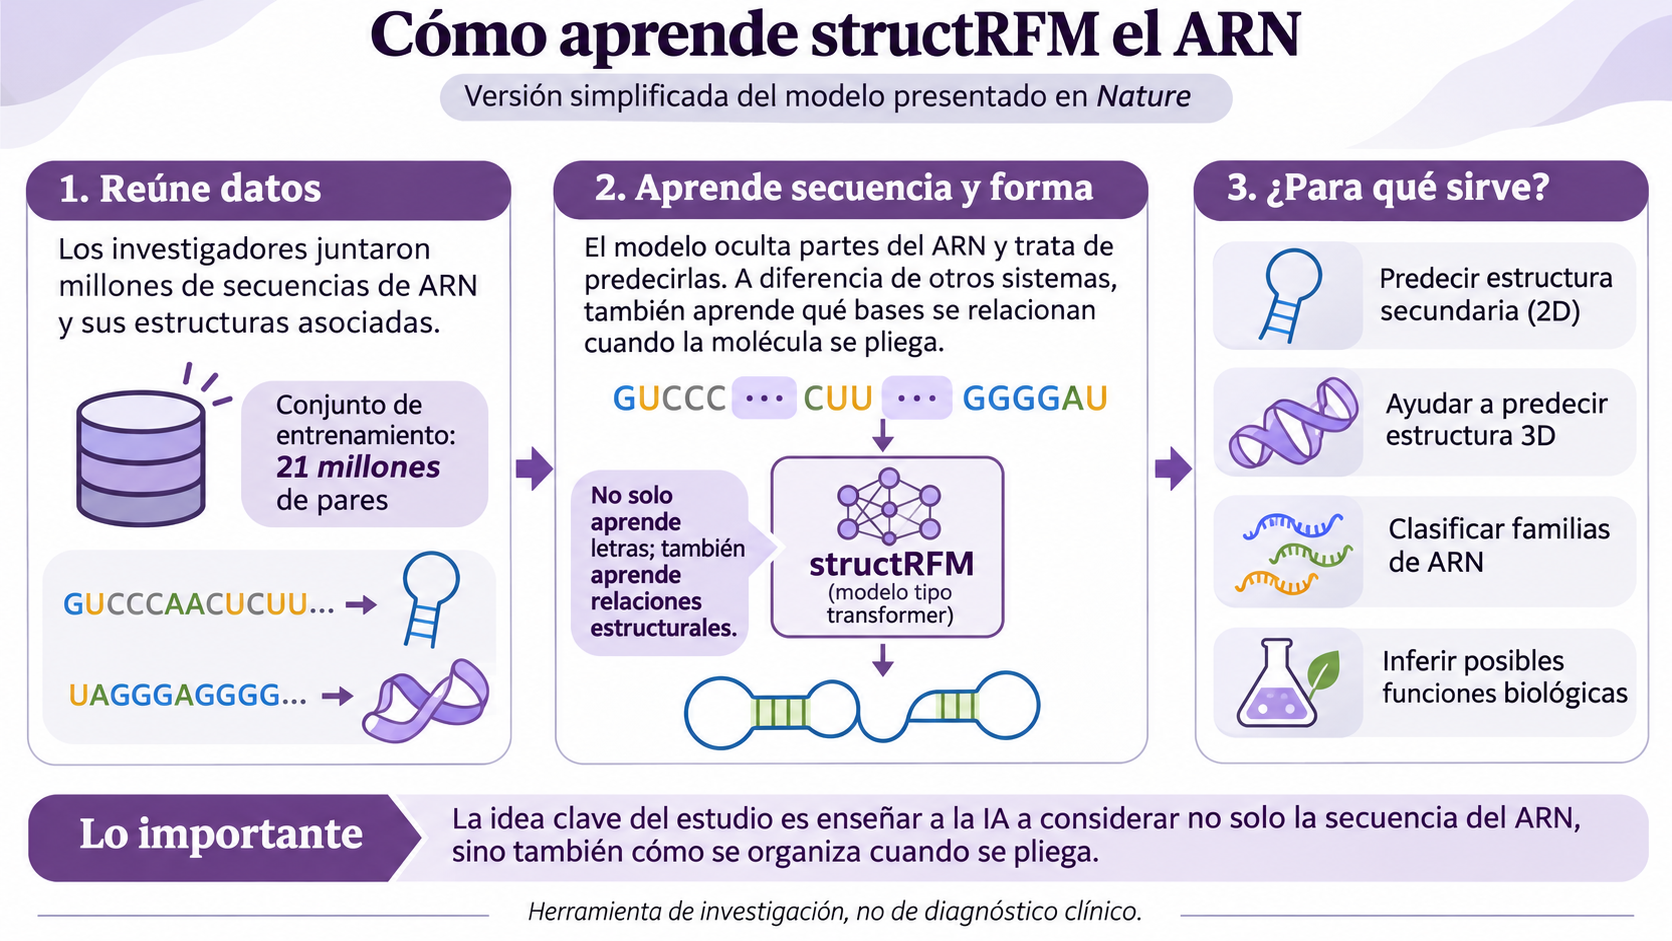
Según el estudio publicado en Nature, el modelo mejora diferentes tareas relacionadas con la predicción de estructuras secundarias, la clasificación de familias moleculares y la identificación de funciones biológicas del ARN. Los investigadores también desarrollaron una adaptación para predecir estructuras tridimensionales, denominada Zfold, que alcanzó resultados comparables a AlphaFold 3 en varios conjuntos de evaluación.
El trabajo fue realizado por científicos de la Universidad de Ciencia y Tecnología de China (USTC), la Universidad de Zhejiang y otras instituciones. Heqin Zhu y Ruifeng Li figuran entre los primeros autores, mientras que Peng Xiong y S. Kevin Zhou aparecen como investigadores de correspondencia.
Posibles aplicaciones en medicina y biología sintética
Aunque structRFM fue desarrollado para predecir estructuras y funciones del ARN, sus capacidades podrían aprovecharse en otras áreas de investigación biomédica. Una posibilidad es el estudio del cáncer, particularmente en el análisis de alteraciones del empalme del ARN y de moléculas no codificantes que participan en la regulación genética. El modelo también podría contribuir a identificar regiones de ARN de interés para el desarrollo de medicamentos o al análisis de mecanismos moleculares relacionados con enfermedades. Sin embargo, estas aplicaciones requerirían adaptaciones, nuevos conjuntos de datos y validaciones independientes; el estudio publicado en Nature no demuestra que structRFM pueda diagnosticar cáncer ni predecir el riesgo de desarrollarlo.
Otra línea potencial es la investigación de virus con genomas de ARN y la biología sintética. La capacidad de analizar relaciones entre secuencias y estructuras podría ayudar a comprender determinadas regiones de ARN viral, investigar sus funciones o estudiar componentes moleculares utilizados en aplicaciones biotecnológicas. Estas posibilidades también plantean cuestiones de bioseguridad y uso dual, especialmente porque el código y los pesos del modelo están disponibles públicamente. No obstante, los autores no demostraron que structRFM pueda diseñar virus sintéticos funcionales ni evaluaron específicamente esa aplicación. Por ahora, se trata de posibles líneas de investigación derivadas de sus capacidades de predicción molecular, no de resultados comprobados del estudio.
Por qué importa conocer la estructura del ARN
El ARN participa en numerosos procesos celulares, desde la producción de proteínas hasta la regulación de la expresión genética. Aunque suele representarse como una cadena de nucleótidos, su funcionamiento también depende de cómo se pliega y de las interacciones que establece entre diferentes regiones de la molécula.
Una secuencia de ARN está formada por cuatro bases principales: adenina, uracilo, citosina y guanina. Estas pueden establecer interacciones que generan regiones apareadas, bucles y otras configuraciones. La disposición de esos elementos constituye su estructura secundaria, mientras que su organización espacial corresponde a la estructura tridimensional o terciaria.
Los modelos de lenguaje aplicados al ARN han conseguido identificar patrones biológicos mediante el análisis de grandes colecciones de secuencias. Sin embargo, los autores del nuevo estudio señalan que aprender únicamente a partir de las letras puede limitar la capacidad de estos sistemas para representar las relaciones estructurales relevantes para las funciones moleculares.
structRFM intenta resolver esa limitación incorporando información sobre las interacciones entre bases durante el preentrenamiento, de manera que el modelo aprenda representaciones conjuntas de la secuencia y la estructura.
Un modelo entrenado con 21 millones de pares de datos
Para desarrollar structRFM, los investigadores construyeron un conjunto de aproximadamente 21 millones de pares de secuencia y estructura de ARN. Estos ejemplos permiten relacionar la composición de las moléculas con posibles configuraciones estructurales.
La arquitectura utiliza una estrategia denominada Structure-guided Masked Language Modeling, que consiste en ocultar partes de la información y entrenar al sistema para reconstruirlas utilizando el contexto disponible. A diferencia de los enfoques basados exclusivamente en nucleótidos individuales, esta técnica incorpora relaciones entre bases que pueden encontrarse alejadas dentro de una misma secuencia.
El equipo también desarrolló MUSES, un método que combina predicciones de estructuras secundarias procedentes de diferentes herramientas computacionales. Su objetivo es reducir la dependencia de un único predictor y limitar los sesgos asociados con las anotaciones estructurales empleadas durante el entrenamiento.
Esta distinción es importante porque los 21 millones de ejemplos no representan 21 millones de estructuras tridimensionales determinadas experimentalmente. Una parte de la información estructural utilizada fue generada mediante métodos de predicción computacional.
Resultados comparables a AlphaFold 3 en determinadas pruebas
Una de las aplicaciones más destacadas del trabajo es Zfold, una adaptación de structRFM orientada a la predicción de estructuras tridimensionales del ARN.
Según los autores, esta variante mejoró la precisión de las estructuras tridimensionales y de las estructuras secundarias derivadas de ellas. En evaluaciones realizadas con conjuntos de referencia como CASP15-natural, CASP16 y RNA-Puzzles, el rendimiento resultó comparable al de AlphaFold 3 en determinadas métricas.
La comparación no significa que structRFM supere de manera general a AlphaFold 3 ni que ambos sistemas tengan las mismas capacidades. AlphaFold 3 está diseñado para predecir estructuras e interacciones de diferentes tipos de moléculas, mientras que structRFM se especializa en aprender representaciones del ARN para diversas tareas de predicción.
El estudio también identifica limitaciones relacionadas con la complejidad de determinadas estructuras. Los resultados varían según las características de las moléculas evaluadas y las interacciones que deben predecirse.
Identificación de familias y funciones biológicas
Además de predecir estructuras, structRFM fue evaluado en tareas de clasificación de ARN y predicción funcional. Los investigadores reportaron un desempeño destacado en clasificación de homología sin ejemplos específicos de entrenamiento para las clases evaluadas, una capacidad conocida como zero-shot. También observaron mejoras en tareas de predicción funcional y resultados favorables con familias de ARN incorporadas recientemente a bases de datos científicas.
Otra aplicación relevante es el análisis de ARN largos no codificantes, moléculas que no se traducen directamente en proteínas y que pueden participar en distintos mecanismos de regulación celular.
Estos resultados sugieren que incorporar información estructural durante el entrenamiento puede ayudar a construir representaciones moleculares reutilizables, en lugar de desarrollar modelos completamente independientes para cada tarea.
Sin embargo, las predicciones informáticas no sustituyen la validación experimental. Identificar una estructura o una posible función mediante inteligencia artificial no demuestra por sí solo que una molécula adopte esa configuración o desempeñe esa actividad en condiciones biológicas reales.
Datos, código y pesos disponibles públicamente
Una característica importante del proyecto es su política de apertura. Los investigadores publicaron el conjunto de entrenamiento de 21 millones de pares de secuencia y estructura, el código fuente y los parámetros de los modelos preentrenados y ajustados.
Los recursos están disponibles mediante GitHub y Zenodo, lo que permite a otros equipos examinar la metodología, ejecutar el software y desarrollar nuevas aplicaciones sobre la arquitectura propuesta. La disponibilidad de estos materiales facilita la reproducción computacional de los experimentos, aunque una evaluación independiente completa también requiere comprobar las condiciones de entrenamiento, los conjuntos de prueba y los resultados publicados.
El estudio plantea una línea de desarrollo para los modelos fundacionales de biología molecular: integrar la información sobre la organización física de las moléculas desde el aprendizaje inicial, en lugar de limitarse al análisis de sus secuencias.
Para la investigación del ARN, este enfoque podría contribuir al desarrollo de herramientas de predicción estructural y funcional más flexibles, siempre que sus resultados continúen sometiéndose a evaluaciones independientes y validación experimental.