Google presenta los sistemas TPU 8tx y TPU 8i Max, especializados en procesamiento confidencial y grandes ventanas de contexto. El anuncio coincide con una caída de las acciones de Nvidia, mientras la investigación sobre Jensen Huang genera incertidumbre entre los inversionistas.
Google presentó este lunes 9 de noviembre de 2026 dos nuevos sistemas de procesamiento para inteligencia artificial, en una jornada marcada por las dificultades de su principal competidor en el mercado de aceleradores, Nvidia. Mientras las acciones de la compañía dirigida por Jensen Huang registraban pérdidas por una investigación interna, Alphabet avanzaba en Wall Street y anunciaba las TPU 8tx y TPU 8i Max, diseñadas para responder a las necesidades de seguridad, memoria y procesamiento de los agentes autónomos.
El anuncio amplía la octava generación de unidades de procesamiento tensorial de Google, conocidas como TPU, con dos configuraciones especializadas. La primera busca proteger información confidencial durante la ejecución de modelos, mientras que la segunda está diseñada para procesar grandes cantidades de contexto, como repositorios completos de código, documentos extensos y horas de video. Según la compañía, ambas responden a las exigencias de una nueva etapa de la inteligencia artificial en la que los sistemas autónomos realizan tareas complejas durante periodos prolongados.
Google aprovecha una jornada de incertidumbre para Nvidia
El lanzamiento ocurre mientras Nvidia enfrenta una controversia sobre su director ejecutivo. El domingo 8 de noviembre, su consejo de administración anunció una investigación independiente para determinar si Jensen Huang había sido objeto de una operación de inteligencia extranjera. Aunque la empresa aseguró que no tiene motivos para creer que se hayan comprometido secretos corporativos o información de seguridad nacional, el anuncio generó inquietud entre los inversionistas.
Durante las primeras operaciones del lunes, las acciones de Nvidia llegaron a registrar caídas cercanas al 8%, mientras que Alphabet avanzó más de 3% tras la presentación de sus nuevos sistemas, según los reportes bursátiles de la jornada. Los movimientos reflejan una diferencia en el comportamiento de ambas compañías, aunque no permiten atribuir exclusivamente al lanzamiento de las TPU la subida de Alphabet ni establecer una relación causal entre los dos acontecimientos.
La coincidencia adquiere relevancia por la competencia entre ambas empresas. Nvidia domina el mercado de aceleradores utilizados para entrenar y ejecutar modelos avanzados de inteligencia artificial, mientras Google amplía su oferta de procesadores propios, desarrollados originalmente para sus servicios internos y posteriormente comercializados mediante Google Cloud.
TPU 8tx: procesar información sensible sin dejarla expuesta
La TPU 8tx está dirigida a organismos gubernamentales, instituciones financieras y empresas de sectores regulados que necesitan ejecutar modelos de inteligencia artificial utilizando información confidencial. Uno de los problemas de seguridad de los sistemas informáticos tradicionales aparece durante el procesamiento de datos. Aunque la información puede permanecer cifrada mientras está almacenada o circula por una red, normalmente debe descifrarse para que el procesador pueda utilizarla. Esto crea una etapa en la que los datos podrían quedar expuestos si se compromete el entorno de ejecución.
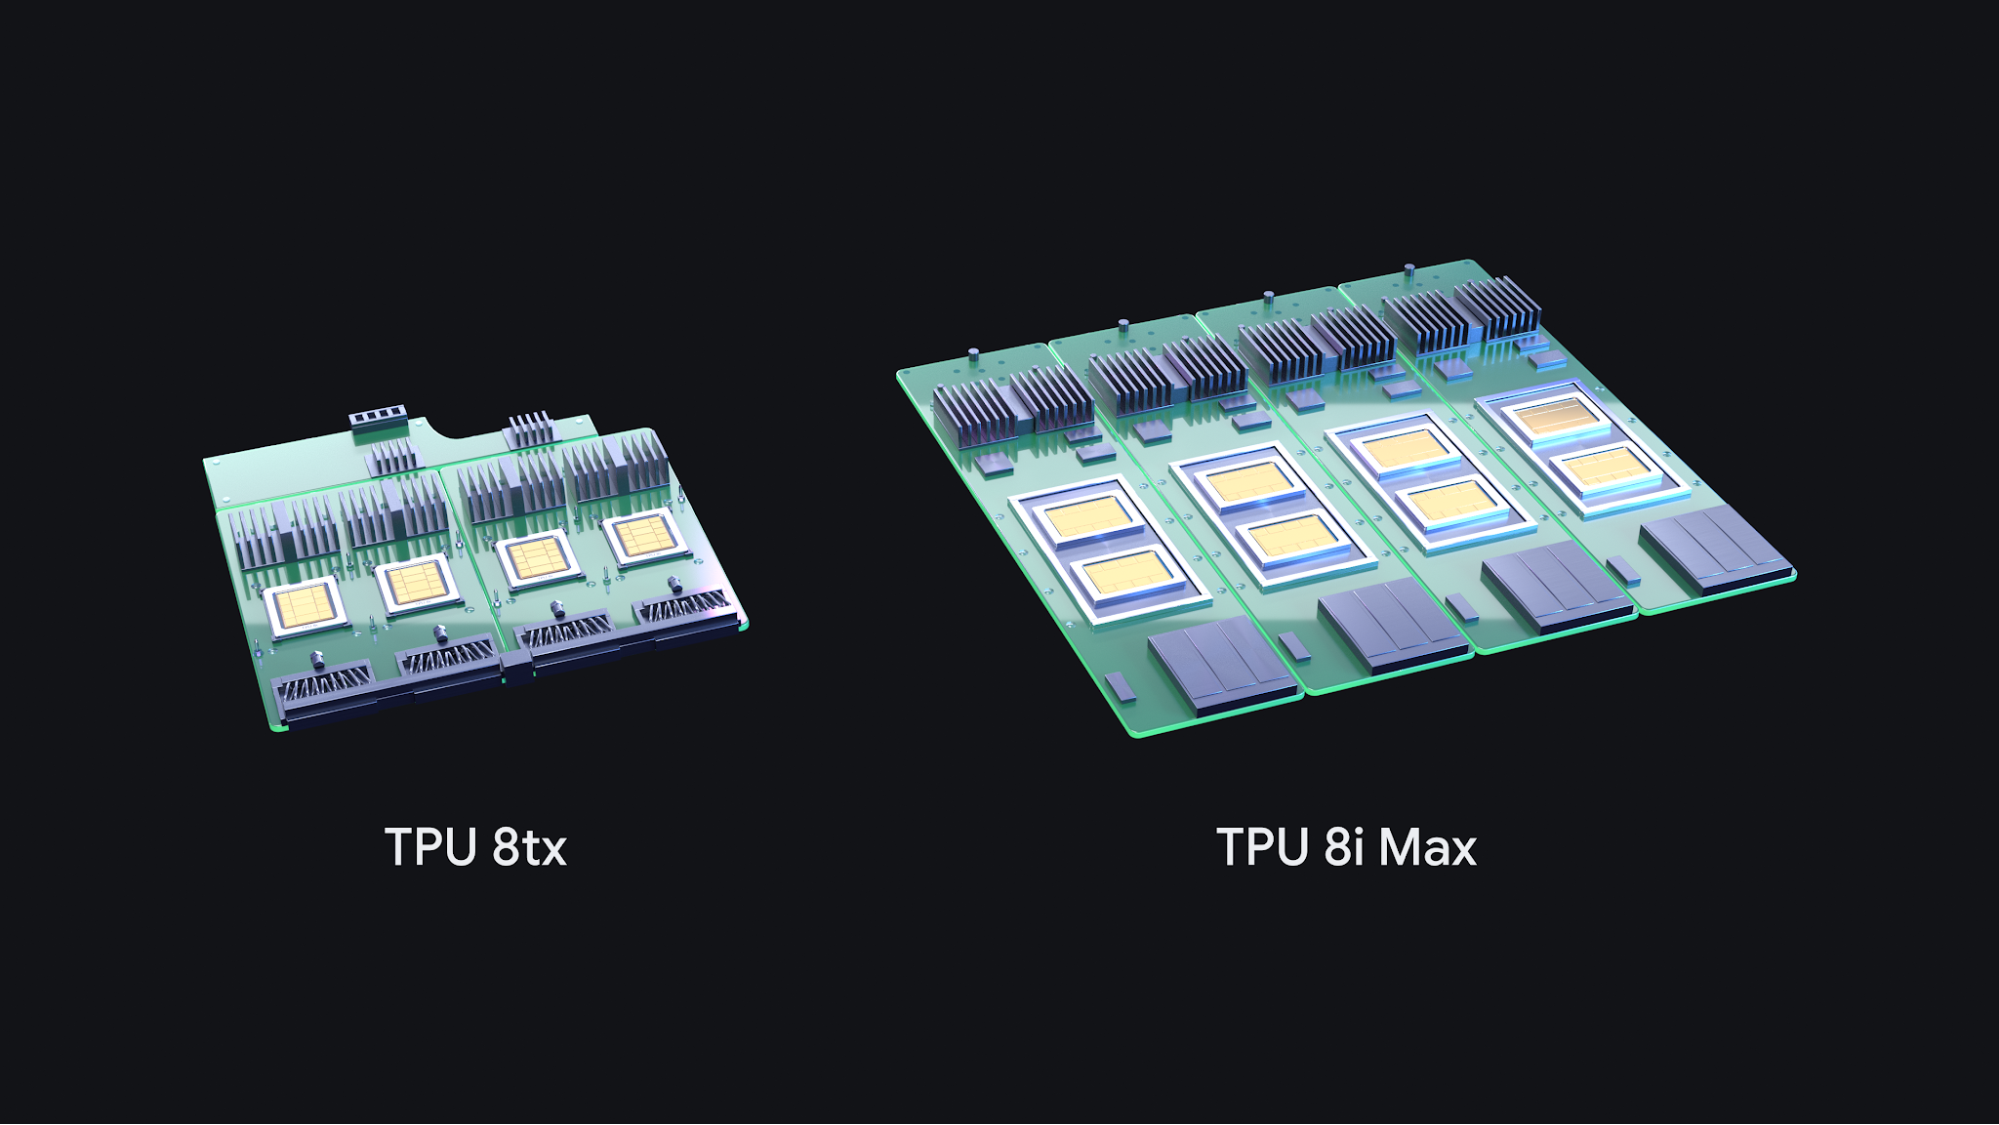
Google afirma que TPU 8tx incorpora mecanismos de aislamiento y protección directamente en el hardware para mantener protegidos los datos sensibles y los parámetros de los modelos mientras se utilizan. El sistema combina el mismo silicio empleado en TPU 8t con procesadores AMD EPYC y una red de baja latencia denominada Boardfly, concebida para acelerar las comunicaciones necesarias durante tareas de razonamiento y ejecución de agentes.
De acuerdo con las mediciones de la compañía, esta configuración puede reducir hasta dos veces la latencia respecto de TPU 8t, con un impacto mínimo en el rendimiento asociado a las protecciones adicionales. Se trata de una comparación publicada por Google y no de una evaluación independiente frente a los aceleradores de Nvidia.
Otra característica es la posibilidad de utilizar una misma infraestructura para ejecutar modelos y adaptarlos mediante ajuste fino, destilación o aprendizaje por refuerzo, sin necesidad de trasladar información privada entre distintos grupos de servidores. Esto puede resultar especialmente útil para empresas que desean desarrollar agentes capaces de consultar documentos internos y realizar operaciones sobre sistemas confidenciales.
TPU 8i Max: más memoria para agentes que trabajan con millones de tokens
La segunda propuesta, TPU 8i Max, aborda una limitación diferente: la cantidad de información que un sistema puede mantener disponible mientras ejecuta tareas complejas. Los agentes de inteligencia artificial no siempre responden a una sola pregunta. Algunos necesitan revisar miles de archivos, consultar herramientas, analizar documentos extensos o coordinarse con otros agentes. Durante estas operaciones, los sistemas deben conservar grandes cantidades de información contextual, lo que incrementa las necesidades de memoria y comunicación entre procesadores.
Google explica que TPU 8i Max combina dos chips TPU 8i en un mismo encapsulado. Esta configuración ofrece el doble de capacidad de cómputo, el doble de memoria SRAM y el doble de ancho de banda de memoria HBM respecto de un TPU 8i individual. Según la compañía, también permite duplicar la cantidad de silicio dentro del espacio físico ocupado por los sistemas anteriores en un rack.
El objetivo es reducir los cuellos de botella que aparecen cuando los modelos trabajan con ventanas de contexto de millones de tokens. Estas ventanas representan la cantidad de información que un sistema puede considerar durante una operación y resultan importantes para agentes dedicados al desarrollo de software, la investigación científica o el análisis de grandes conjuntos documentales.
La duplicación de recursos de memoria y cómputo no significa, por sí sola, que cualquier modelo pueda utilizar automáticamente una ventana de contexto dos veces mayor. La capacidad efectiva también depende de la arquitectura del modelo, el software y la manera en que se administra la memoria.
Google acelera el desarrollo sin fabricar una arquitectura completamente nueva
Una de las características más relevantes del anuncio es que Google no necesitó diseñar dos arquitecturas de chips desde cero. Amin Vahdat, vicepresidente sénior y responsable tecnológico de infraestructura de IA de Google, explicó que el desarrollo de un nuevo semiconductor puede requerir varios años, mientras que modificar su integración con memoria, redes y otros componentes permite crear sistemas especializados en periodos mucho más cortos.
Esta estrategia permite adaptar el hardware a necesidades que evolucionan más rápidamente que los ciclos de fabricación de semiconductores. Google había presentado las TPU 8t y TPU 8i en abril de 2026 para entrenamiento de gran escala y razonamiento de baja latencia, respectivamente. Con las nuevas configuraciones, la compañía completa cuatro sistemas de octava generación anunciados durante el mismo año.
El enfoque también muestra cómo la competencia por la infraestructura de inteligencia artificial está extendiéndose más allá de la potencia máxima de los procesadores. Las compañías necesitan optimizar el movimiento de información, el consumo energético, la utilización de memoria y los mecanismos de seguridad para ejecutar aplicaciones cada vez más complejas.
Google también busca reducir la dependencia de Nvidia mediante software
El anuncio no se limita al hardware. Google está ampliando las herramientas disponibles para ejecutar programas de inteligencia artificial sobre sus procesadores TPU. La compañía destacó TorchTPU, un proyecto de código abierto que permite utilizar modelos desarrollados con PyTorch, uno de los entornos más utilizados en investigación y desarrollo de IA, sobre infraestructura TPU. Google sostiene que esta integración busca eliminar la necesidad de reescribir código al trasladar cargas de trabajo desde otros sistemas.
También presentó nuevas herramientas para automatizar la optimización de programas, diagnosticar problemas de rendimiento y facilitar la ejecución de aplicaciones desarrolladas con tecnologías abiertas. Entre ellas se encuentran una colección de agentes especializados en TPU, disponible en versión preliminar, y mejoras para motores de inferencia como vLLM y SGLang.
Otro componente es TPU Sync, una capa de software que permite coordinar la memoria de los aceleradores, la memoria de los servidores y los sistemas de almacenamiento. Google afirma que determinadas optimizaciones pueden reducir más de 90% la latencia de transferencia de información contextual y el tiempo necesario para generar el primer token. Estas cifras corresponden a evaluaciones de la compañía sobre su software, no a una mejora universal de todas las cargas de trabajo.
La empresa también anunció Agent Compute Engine, un mecanismo diseñado para suspender sesiones de agentes mientras esperan respuestas de herramientas externas, consultas a bases de datos o intervenciones humanas. El sistema busca evitar que los aceleradores permanezcan ocupados durante periodos de inactividad, reduciendo el desperdicio de capacidad informática.
Estas herramientas resultan relevantes porque la posición de Nvidia no depende únicamente de sus procesadores gráficos. También se apoya en un ecosistema de programación y herramientas que permite a desarrolladores y empresas utilizar sus equipos. Ampliar la compatibilidad de las TPU con tecnologías abiertas puede reducir algunas barreras para adoptar alternativas de hardware.
La competencia por los agentes de IA abre una nueva etapa
Google asegura que su negocio de TPU cuenta con cerca de 100 clientes, entre ellos laboratorios de investigación, universidades, empresas comerciales y organizaciones dedicadas al desarrollo de modelos avanzados. Reuters también reportó que las ventas de estos procesadores contribuyeron a los resultados recientes de Alphabet, mientras Google Cloud continúa ampliando su negocio de infraestructura.
Sin embargo, el anuncio todavía no demuestra que las nuevas TPU superen de manera general a los sistemas de Nvidia. Google no proporciona en su publicación principal una comparación independiente de rendimiento y costo frente a las GPU de su competidor, ni detalla precios y fechas de disponibilidad general para ambas configuraciones.
La importancia del lanzamiento reside en la especialización de la infraestructura. Mientras los primeros años de expansión de la inteligencia artificial estuvieron dominados por la necesidad de aumentar la capacidad de entrenamiento de grandes modelos, las nuevas aplicaciones requieren sistemas capaces de mantener información contextual, coordinar herramientas y ejecutar operaciones durante periodos prolongados.
En una jornada complicada para Nvidia, Google presenta una estrategia que busca competir no solamente mediante aceleradores más potentes, sino mediante sistemas diseñados alrededor de las necesidades de los agentes autónomos. El anuncio no modifica de inmediato el liderazgo de Nvidia, pero amplía las alternativas disponibles para desarrollar y desplegar la próxima generación de aplicaciones de inteligencia artificial.