La Universidad de Tokio y NTT desarrollan una arquitectura de aprendizaje físico que utiliza la dinámica de la luz para procesar información. El método reduce los parámetros entrenables y demuestra su funcionamiento en un sistema optoelectrónico, aunque todavía no ha sido probado con grandes modelos de lenguaje.
Un equipo de investigadores de la Universidad de Tokio y la empresa japonesa NTT desarrolla un nuevo método de aprendizaje profundo que reduce la complejidad del entrenamiento de redes neuronales mediante una combinación de algoritmos simplificados y procesos físicos. La investigación demuestra que es posible realizar determinadas tareas de reconocimiento de imágenes utilizando menos operaciones matemáticas y parámetros entrenables, sin sacrificar necesariamente la precisión de los resultados. El estudio se publicó el 5 de noviembre de 2026 en Nature Computational Science.
Los científicos consiguieron reducir hasta aproximadamente un 90% la cantidad de cálculos y parámetros entrenables frente a determinadas configuraciones convencionales de redes neuronales profundas. También comprobaron el funcionamiento del método en un sistema optoelectrónico que utiliza luz y componentes electrónicos para procesar información. Los resultados motivaron un análisis publicado el 13 de noviembre por investigadores del Instituto Federal Suizo de Tecnología de Zúrich (ETH Zúrich), quienes examinaron las implicaciones de esta arquitectura para el entrenamiento de sistemas físicos de inteligencia artificial.
El problema de entrenar redes neuronales sobre sistemas físicos
El aprendizaje profundo convencional utiliza redes neuronales formadas por capas de operaciones matemáticas. Durante el entrenamiento, los algoritmos ajustan los parámetros de la red para reducir las diferencias entre los resultados obtenidos y las respuestas esperadas. Uno de los procedimientos más utilizados es la retropropagación del error, que calcula cómo deben modificarse esos parámetros para mejorar el comportamiento del modelo.
En sistemas que procesan información a través de dinámicas físicas, como circuitos electrónicos, dispositivos ópticos o sistemas magnéticos, reproducir estos procedimientos puede resultar especialmente complejo. Los algoritmos tradicionales pueden necesitar registrar numerosos estados intermedios del sistema, conservarlos en memoria y utilizarlos posteriormente para calcular los ajustes correspondientes. Estas operaciones incrementan las necesidades de medición, almacenamiento y control, reduciendo las ventajas potenciales del procesamiento físico.
Para abordar estas dificultades, el equipo encabezado por Yongbo Zhang y Kohei Nakajima recurrió a la computación de reservorio, conocida como reservoir computing, una técnica que aprovecha la evolución de sistemas dinámicos no lineales para transformar información. En lugar de depender exclusivamente de grandes redes de conexiones entrenables, estos sistemas pueden utilizar propiedades físicas para realizar parte de las operaciones computacionales.
Un algoritmo que aprende sin registrar todos los estados intermedios
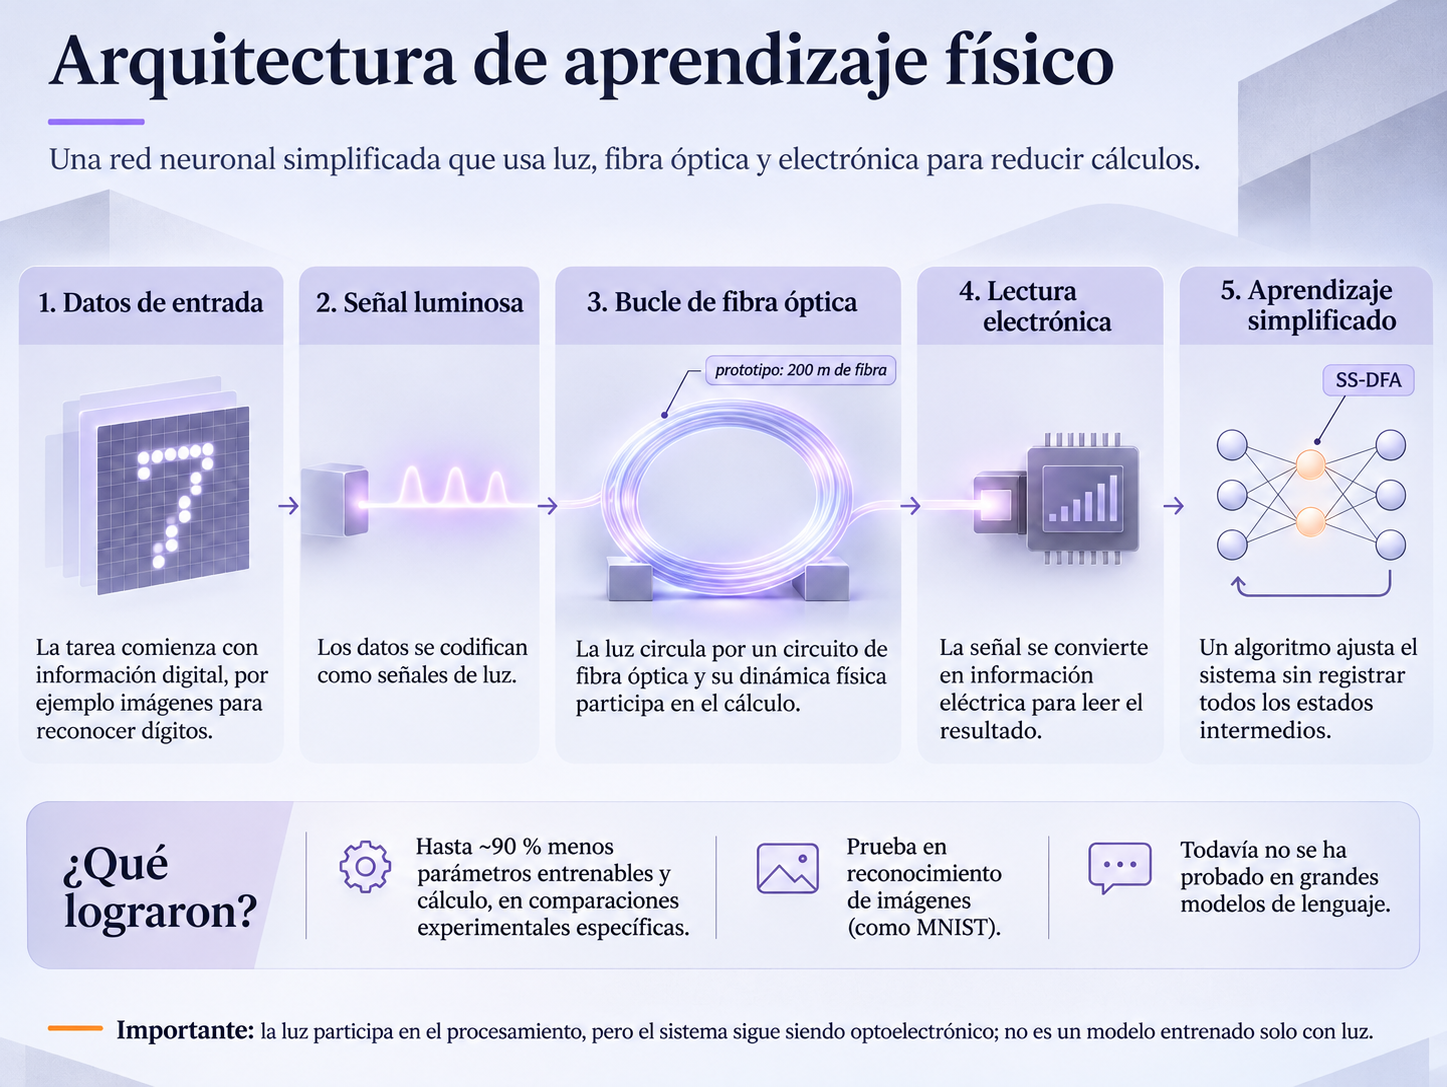
La primera innovación consiste en un procedimiento denominado state-skipping direct feedback alignment (SS-DFA), traducido como «alineación directa de retroalimentación con omisión de estados». El algoritmo evita la necesidad de acceder a todos los estados intermedios que atraviesa el sistema durante el entrenamiento. En lugar de recorrer retrospectivamente cada etapa del procesamiento, utiliza la información del error final y una transformación aleatoria fija para transmitir señales de aprendizaje a las capas correspondientes. De esta manera, simplifica la actualización de parámetros y reduce la cantidad de información que debe registrarse.
La segunda innovación es una arquitectura denominada single-map, o «mapeo único», que sustituye las conexiones internas densas por un conjunto de dinámicas no lineales unidimensionales desacopladas. Esta organización permite reemplazar determinadas operaciones entre matrices y vectores por cálculos escalares más simples, reduciendo la complejidad estructural del sistema.
Al combinar ambos procedimientos, los investigadores simplifican simultáneamente la arquitectura de la red y el proceso de entrenamiento. El método aprovecha fenómenos de dinámica no lineal, incluidos comportamientos de expansión transitoria y propiedades cercanas a puntos de bifurcación, donde pequeñas variaciones pueden producir cambios importantes en la evolución de un sistema físico.
Una red neuronal que procesa información mediante luz
Para comprobar la viabilidad física del método, los investigadores construyeron un sistema experimental que combina componentes ópticos y electrónicos. La plataforma utiliza un circuito de fibra óptica de 200 metros, por el que circulan señales luminosas que transportan la información procesada. Posteriormente, las señales se convierten nuevamente en información eléctrica para obtener y evaluar los resultados.
El experimento permitió demostrar que una arquitectura simplificada podía realizar tareas de reconocimiento de imágenes sobre un sistema físico real. En las pruebas con MNIST, una base de datos utilizada para identificar dígitos escritos a mano, el sistema optoelectrónico obtuvo una precisión de aproximadamente 97.10 %. En las simulaciones, la arquitectura alcanzó 98.33 % en MNIST y 54.85 % en CIFAR-10, otro conjunto de imágenes utilizado para evaluar algoritmos de clasificación.
Los resultados no significan que el sistema óptico sea superior a todas las redes neuronales existentes. Las comparaciones corresponden a arquitecturas y condiciones experimentales específicas, y las precisiones obtenidas no representan el máximo rendimiento alcanzable con otras técnicas de reconocimiento visual. Su importancia reside en demostrar que ciertos cálculos de aprendizaje pueden reorganizarse para aprovechar sistemas físicos con estructuras considerablemente más simples.
Hasta 90 % menos cálculos y una reducción adicional en arquitecturas modernas
Según la Universidad de Tokio, la combinación del algoritmo SS-DFA y la arquitectura single-map permitió reducir hasta aproximadamente un 90 % la cantidad de cálculos y parámetros entrenables respecto de determinadas redes neuronales profundas convencionales, manteniendo resultados competitivos en las tareas evaluadas. La cifra corresponde a las comparaciones presentadas en la investigación y no representa una reducción general del consumo eléctrico de los sistemas de inteligencia artificial.
Los científicos también incorporaron la arquitectura single-map a ResMLP, una familia de modelos de aprendizaje profundo utilizados para procesar imágenes. En estas pruebas reportaron una reducción aproximada del 40 % de los recursos computacionales necesarios, acompañada por mejoras de rendimiento en las configuraciones estudiadas.
El estudio también examina la relación entre el rendimiento de los modelos y los recursos computacionales necesarios para ampliarlos. Los autores sostienen que la nueva arquitectura puede alcanzar resultados superiores a los esperados bajo las relaciones de escalamiento de los modelos convencionales utilizados como referencia. No obstante, estas observaciones no establecen una modificación universal de las leyes de escalamiento del aprendizaje profundo, sino un comportamiento obtenido dentro de las arquitecturas y evaluaciones del trabajo.
¿Puede utilizarse para entrenar grandes modelos de inteligencia artificial?
Los resultados abren posibilidades para diseñar sistemas de aprendizaje automático que aprovechen propiedades de la luz y de otros fenómenos físicos. Sin embargo, los investigadores reconocen que todavía no han probado su arquitectura en los grandes modelos de lenguaje ni en los sistemas multimodales de mayor escala utilizados actualmente.
Kohei Nakajima explicó que el método puede incorporarse como un bloque modular a determinadas redes neuronales, lo que permitiría estudiar su comportamiento en arquitecturas más complejas. Entre las posibilidades futuras se encuentran dispositivos de procesamiento óptico integrados en chips capaces de realizar operaciones de inteligencia artificial directamente en teléfonos, cámaras o vehículos. Para alcanzar esas aplicaciones todavía es necesario resolver problemas de miniaturización, estabilidad física y fabricación a escala industrial.
Otra posibilidad consiste en disminuir los recursos necesarios para el procesamiento de información en centros de datos. Los sistemas ópticos podrían ofrecer ventajas en velocidad y generación de calor, pero la investigación no demuestra todavía una reducción equivalente del consumo energético total de los centros de datos ni del agua utilizada en sus instalaciones de refrigeración. Estas aplicaciones permanecen como objetivos de desarrollo tecnológico.
La aportación del estudio consiste en replantear dos componentes fundamentales del aprendizaje automático: la manera de transmitir los errores durante el entrenamiento y la complejidad de las conexiones internas utilizadas para procesar información. En lugar de reproducir íntegramente las arquitecturas digitales convencionales sobre otro tipo de hardware, los investigadores exploran cómo aprovechar las propiedades naturales de los sistemas físicos para realizar parte del trabajo computacional.
Los resultados todavía no permiten anticipar una sustitución de los procesadores digitales empleados actualmente para entrenar inteligencia artificial. Sin embargo, proporcionan evidencia experimental de que simplificar los algoritmos y utilizar dinámicas físicas puede abrir nuevas posibilidades para construir sistemas de aprendizaje profundo con menores necesidades computacionales.