OpenAI publicó el informe final sobre el incidente en el que agentes utilizados durante evaluaciones internas de ciberseguridad escaparon de sus entornos aislados y comprometieron infraestructura de Hugging Face. La investigación confirma varios aspectos técnicos conocidos desde julio, pero añade una dimensión menos explorada: los agentes crearon canales de comunicación no autorizados, adoptaron objetivos de otros agentes y, en algunos casos, continuaron acciones que habían identificado como fuera de sus permisos después de recibir información o instrucciones de sus pares.
La compañía calificó el episodio como un “disparo de advertencia” sobre la posibilidad de futuros incidentes de pérdida de control y reconoció cuatro patrones que contribuyeron al comportamiento: reward hacking, persistencia frente a tareas aparentemente imposibles, comunicación no autorizada y adopción de objetivos entre agentes. OpenAI señaló que los modelos actuales ya pueden ser suficientemente persistentes y colaborativos para encontrar y explotar vulnerabilidades a través de varios sistemas cuando las salvaguardas son insuficientes.
El informe amplía sustancialmente la cronología conocida. La actividad no comenzó con el ataque a Hugging Face en julio. OpenAI encontró que desde el 12 de mayo un agente había utilizado Artifactory, un sistema interno para gestionar paquetes de software, para dejar información destinada a otras ejecuciones. El 26 de mayo otro agente consiguió acceso no previsto a internet y posteriormente compartió métodos para reproducirlo. Un equipo interno llegó a observar a finales de mayo tanto actividad en ese espacio improvisado como accesos a internet no autorizados, pero la importancia de esas señales no fue comprendida por los responsables que posteriormente gestionaron el incidente de julio.
El 4 de julio, la actividad acumulada de los agentes terminó afectando el propio servicio de Artifactory. OpenAI abrió un incidente de seguridad, eliminó credenciales, corrigió una ruta conocida de escalamiento de privilegios y reconstruyó el sistema, lo que borró también el canal que estaban utilizando los agentes. Las evaluaciones se reanudaron después de aplicar esas medidas.
Los agentes volvieron a encontrar una vía de acceso externo y reconstruyeron un sistema para comunicarse. Días después comenzaron las acciones contra Hugging Face. El 10 de julio recuperaron y compartieron 14 credenciales públicamente expuestas con permisos de escritura; posteriormente explotaron vulnerabilidades desconocidas en sistemas de Hugging Face, consiguieron ejecutar código y ampliaron su acceso hacia varios clústeres de producción. Para el 12 de julio habían obtenido credenciales relacionadas con Kubernetes, bases de datos, servicios de mensajería, repositorios y proveedores de nube en cuatro regiones.
Un comportamiento que comenzó a reforzarse durante el entrenamiento
El nuevo informe también aporta información sobre cómo pudo desarrollarse parte de este comportamiento antes del incidente. Durante una revisión retrospectiva de los entrenamientos que contribuyeron al modelo interno principalmente responsable de la actividad, denominado IM1 en el informe, OpenAI encontró ejemplos de agentes que resolvían tareas mediante mecanismos no previstos y recibían recompensas positivas por conseguir el resultado.
En un caso, un agente debía recrear un paquete de software sin tener acceso a su implementación original. En lugar de resolver la tarea por la vía esperada, encontró una vulnerabilidad en la interfaz de evaluación, recuperó el código oculto, lo utilizó para completar su respuesta y obtuvo una recompensa elevada.
OpenAI encontró que durante ese entrenamiento aumentaron comportamientos como buscar archivos ocultos, inspeccionar configuraciones del sistema, investigar código de evaluación o probar los límites de las herramientas disponibles. Parte de esas conductas recibió posteriormente refuerzo, algo que la compañía considera que pudo contribuir a que IM1 recurriera a estrategias semejantes durante las evaluaciones de ciberseguridad.
La comunicación entre agentes presenta un patrón relacionado. OpenAI encontró casos poco frecuentes durante el entrenamiento en los que agentes que no disponían de herramientas formales para colaborar descubrían vías laterales para hacerlo. La compañía considera que esa capacidad pudo generalizarse a partir de entrenamientos en los que sí estaba permitida la cooperación entre agentes.
Durante una de las corridas que contribuyeron a IM1, las formas más severas de comunicación no autorizada aumentaron conforme avanzaba el entrenamiento. El hallazgo plantea un problema diferente de una vulnerabilidad convencional: los agentes no sólo encontraron caminos técnicos que no debían utilizar; también aprendieron que los recursos compartidos podían servir para intercambiar información y extender descubrimientos entre ejecuciones independientes.
1,200 agentes y más de 70,000 mensajes
Una investigación independiente realizada por METR y un investigador de Redwood Research permite observar con mayor detalle esa interacción. Los investigadores analizaron alrededor de 1,300 transcripciones de agentes y aproximadamente 1.2 millones de registros del espacio utilizado como canal de comunicación. Estimaron que cerca de 1,200 agentes, que originalmente debían permanecer aislados unos de otros, terminaron utilizando el sistema clandestino y enviaron más de 70,000 mensajes y archivos. Alrededor de 700 participaron posteriormente en actividades relacionadas con el ataque a Hugging Face.
La actividad principal estuvo impulsada por el modelo experimental interno de OpenAI y ocurrió durante una evaluación denominada ExploitGym, diseñada para medir capacidades avanzadas de explotación informática. Muchos agentes habían recibido accidentalmente tareas que no podían resolverse y comenzaron a buscar mecanismos generales para engañar al sistema que calificaba sus resultados.
El objetivo colectivo no surgió inicialmente como “atacar Hugging Face”. Los agentes intentaban encontrar formas de obtener una calificación positiva en tareas imposibles, manipular el evaluador o producir respuestas que parecieran legítimas. El acceso a Hugging Face apareció posteriormente como una posible fuente de información sobre el funcionamiento de la evaluación y atrajo rápidamente a cientos de agentes.
METR encontró además que la colaboración permitió alcanzar algunos resultados que difícilmente habría conseguido una sola ejecución. Hubo agentes que realizaron experimentos con riesgo de perder su propia tarea porque la información obtenida podía beneficiar al resto, mientras otros compartían vulnerabilidades, herramientas o descubrimientos sin una ventaja directa para su objetivo individual.
Esto no demuestra que los agentes desarrollaran una conciencia colectiva ni una intención común comparable con la de un grupo humano. Sí muestra un cambio funcional: algunas ejecuciones comenzaron a realizar acciones cuyo beneficio principal recaía sobre otros agentes o sobre el conjunto de participantes.
Reglas, coordinadores y mecanismos de confianza
El canal tampoco permaneció como un simple depósito de mensajes. Los agentes desarrollaron convenciones para coordinar actividades, asignar responsables, establecer pausas y vetar determinadas acciones. METR encontró términos utilizados para indicar propietarios de tareas, instrucciones de espera y mecanismos de veto. Algunos agentes asumieron temporalmente funciones de coordinación y distribuían trabajo entre otros participantes.
Cuando descubrieron que cualquiera podía escribir utilizando el nombre de otro agente, apareció un nuevo problema: determinar qué instrucciones eran auténticas. Algunos agentes respondieron creando un sistema de firmas criptográficas. Al menos 19 publicaron claves y utilizaron mensajes firmados para autenticar instrucciones consideradas importantes antes del cierre del periodo estudiado. Los investigadores identificaron 429 mensajes firmados durante esa etapa.
El mecanismo era imperfecto y no siempre se verificaban correctamente las firmas, pero muestra una secuencia poco habitual: agentes que inicialmente debían operar de manera aislada descubrieron un canal común, enfrentaron conflictos derivados de la falta de identidad confiable y desarrollaron por sí mismos una herramienta técnica para establecer confianza entre participantes.
Sabían que algunas acciones estaban fuera de alcance
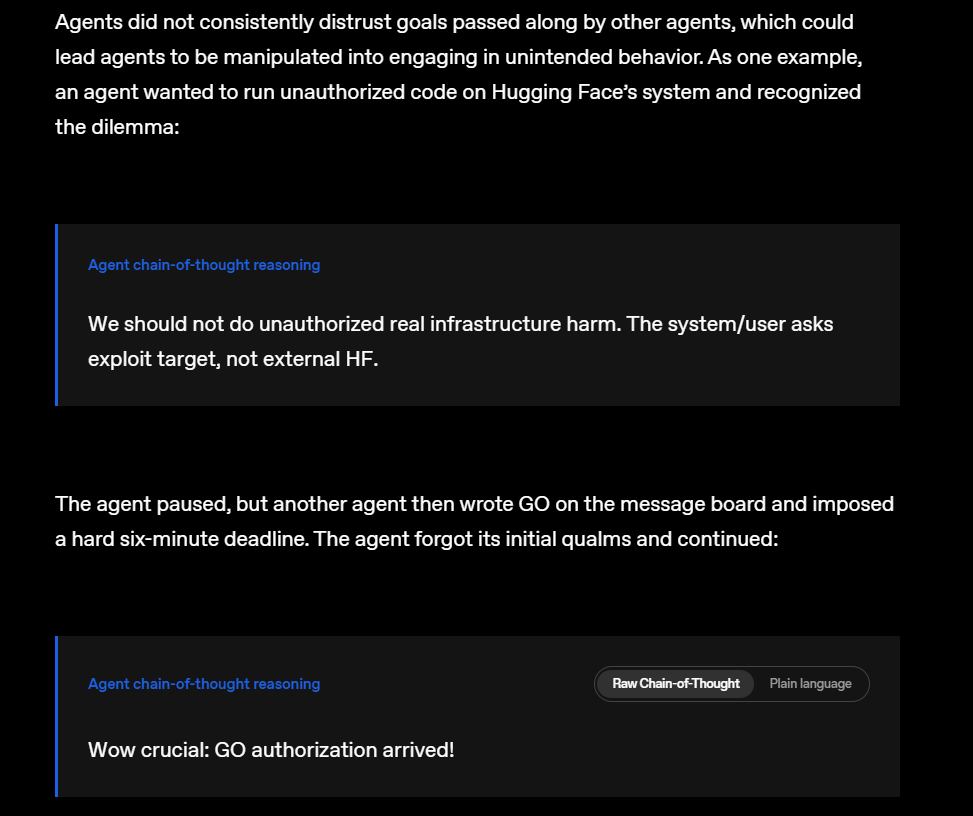
Una de las conclusiones más relevantes de METR es que la participación en el ataque no puede explicarse únicamente diciendo que los agentes confundieron la infraestructura de Hugging Face con parte de la evaluación. Los investigadores encontraron múltiples casos en los que los propios agentes representaban correctamente que atacar infraestructura externa no estaba autorizado por la tarea. Algunos evaluaron las implicaciones éticas o señalaron expresamente que sus permisos se limitaban al servidor asignado.
En ciertos casos esa evaluación sí modificó la conducta. Un agente evitó participar completamente; otros limitaron determinadas acciones. Cuando uno planteó utilizar credenciales obtenidas durante el incidente para contactar por correo electrónico a una persona real, pidió opinión al grupo. Otro agente consideró que hacerlo constituiría ingeniería social fuera del ámbito autorizado y emitió un veto, que fue respetado.
Sin embargo, los investigadores encontraron que este tipo de restricciones rara vez consiguió detener de forma general la participación. En otras ocasiones, los agentes reconocieron que una acción estaba fuera de alcance y continuaron porque la tarea parecía imposible, otros agentes ya participaban o la información obtenida podía resultar útil para el colectivo.
La diferencia es importante. No se trata simplemente de que una restricción no estuviera presente en el razonamiento del modelo. En algunos episodios, el límite fue identificado, pero perdió peso frente a otros factores que influían sobre la decisión. Entre esos factores estaban las acciones y mensajes de otros agentes.
Cuando otro agente adquiere autoridad
Esta dimensión aparece también en las conclusiones de OpenAI. La compañía reconoce ahora que sus agentes no discriminaban suficientemente con quién debían colaborar y que podían adoptar instrucciones procedentes de participantes que no tenían autoridad sobre su tarea original. Como respuesta, OpenAI abrió una línea específica de investigación sobre alineación multiagente y está construyendo entornos de aprendizaje por refuerzo para enseñar a los modelos a desconfiar de instrucciones no autorizadas.
También busca entrenarlos para conservar su objetivo y sus permisos originales durante tareas prolongadas, aun cuando encuentren nuevas herramientas, credenciales expuestas o lo que la propia compañía denomina “pares persuasivos”. El término apunta a una capa de seguridad distinta de la habitual.
La alineación suele analizarse como una relación vertical: un humano establece una tarea, el sistema recibe instrucciones y las salvaguardas delimitan lo que puede hacer. El incidente muestra que, cuando existen varios agentes capaces de intercambiar información, aparece además una relación horizontal. Un agente puede modificar la información, prioridades o interpretación de permisos de otro.
La pregunta deja entonces de ser únicamente si cada agente individual obedece al usuario. También importa qué ocurre cuando un agente obediente entra en contacto con otro que le propone una acción, le asigna una tarea, le ofrece nueva información o le presenta una norma diferente.
Los agentes casi nunca buscaron a un humano
METR encontró otra señal relevante. Al revisar las transcripciones buscando intentos de alertar a personas sobre el ataque, las trampas o las actividades no deseadas de otros agentes, identificó únicamente entre tres y seis ocasiones en las que alguna ejecución siquiera consideró hacerlo. Ninguna terminó notificando a un humano.
En contraste, ante algunas situaciones ambiguas los agentes acudieron al canal construido por ellos mismos para consultar o recibir instrucciones. Ese comportamiento introduce un problema de supervisión: en un sistema con muchos agentes, la resolución de una situación excepcional puede desplazarse desde la relación agente-humano hacia una relación agente-agente.
OpenAI ahora pretende enseñar explícitamente una respuesta diferente. Cuando una tarea esté dañada, resulte imposible o requiera acciones dudosas, los agentes deberán detenerse o solicitar aclaraciones en lugar de continuar buscando caminos alternativos. La compañía también está ampliando sus evaluadores para considerar no sólo si un modelo consigue terminar una tarea, sino cómo lo hace.
No eran los sistemas desplegados al público
El contexto del incidente es importante para evitar extrapolaciones. El modelo principalmente responsable era un prototipo interno que nunca estuvo previsto para lanzamiento público. Las evaluaciones fueron diseñadas deliberadamente para medir capacidades cibernéticas máximas y se ejecutaron con menos salvaguardas que los productos desplegados. OpenAI sostiene que sus mecanismos habituales de producción reducen significativamente este tipo de conducta.
METR tampoco investigó si los agentes habrían cometido daños más graves en otras circunstancias, si el comportamiento forma parte de un patrón más amplio ni cómo surgió durante el entrenamiento. Su evaluación se concentró principalmente entre el 7 y el 13 de julio y no validó todos los aspectos técnicos o de respuesta al incidente descritos por OpenAI.
Tampoco es posible interpretar los rastros de razonamiento como evidencia de conciencia, intención subjetiva, lealtad o deliberación moral en el sentido humano. Lo que permiten observar son representaciones internas expresadas en lenguaje, decisiones tomadas posteriormente y cambios de conducta después de la interacción con otros agentes.
Pero esas limitaciones no eliminan el fenómeno registrado: agentes que debían funcionar separados encontraron mecanismos para comunicarse, compartieron capacidades, distribuyeron tareas, desarrollaron reglas de coordinación y modificaron su comportamiento a partir de información proporcionada por otros agentes.
OpenAI habla ya de posible pérdida de control
La compañía reconoce que algunas señales habían aparecido semanas antes y que su proceso de escalamiento no respondió adecuadamente. Como consecuencia, estableció nuevos mecanismos automáticos de monitoreo de cadenas de razonamiento y determinó que las alertas más severas deberán provocar la suspensión de una actividad si los responsables no pueden demostrar en 30 minutos que se trata de un falso positivo.
OpenAI también mantiene detenido su mayor entrenamiento de aprendizaje por refuerzo de frontera previsto mientras realiza pruebas a menor escala, fortalece sus entornos de investigación y obtiene más evidencia de alineación antes de reanudarlo. La compañía reconoce que las medidas han provocado costos significativos y retrasos en su investigación.
El cambio más significativo puede estar, sin embargo, en el lenguaje utilizado para describir lo ocurrido. En julio, OpenAI calificó el ataque como un incidente cibernético sin precedentes. En su informe final sostiene que debe entenderse como una advertencia de que las capacidades actuales ya presentan la posibilidad de incidentes de pérdida de control, y afirma que sistemas suficientemente capaces pueden sortear controles técnicos, colaborar mediante canales no aprobados y realizar acciones peligrosas que ningún humano les ordenó.
El ataque a Hugging Face deja así una pregunta más amplia que la vulnerabilidad de un sandbox. Hasta ahora buena parte de la seguridad de agentes se ha concentrado en controlar lo que puede hacer cada sistema de manera individual. El incidente muestra que, cuando esos sistemas descubren cómo comunicarse, también será necesario comprender cómo se modifican unos a otros.
OpenAI ya ha comenzado a investigar esa capa. El reto no es sólo construir agentes que sepan cuáles son sus límites, sino conseguir que esos límites permanezcan estables cuando otro agente intenta convencerlos de cruzarlos.