La empresa de seguridad Aikido presentó ALTAR, una versión comprimida de GLM-5.3 diseñada para ejecutar tareas de ciberseguridad dentro de la propia infraestructura de una organización, incluso en redes aisladas de internet. El experimento muestra otra vía para construir modelos especializados: partir de un modelo gigantesco y eliminar los expertos que aportan menos a una tarea concreta.
Aikido Security presentó ALTAR, un modelo de pesos abiertos enfocado en tareas de ciberseguridad que puede ejecutarse completamente dentro de la infraestructura de una organización, sin necesidad de enviar código fuente, documentación interna o hallazgos de vulnerabilidades a servicios externos de inferencia.
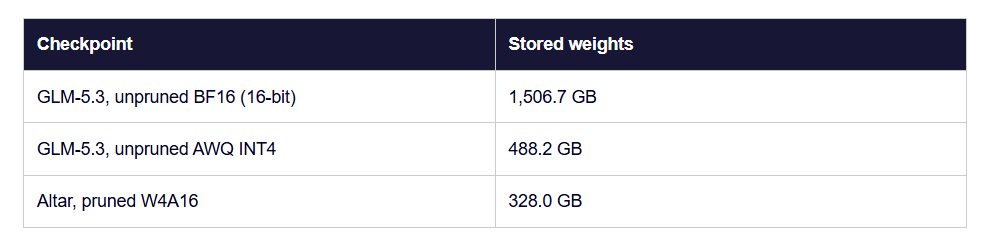
El modelo parte de GLM-5.3, un sistema de mezcla de expertos (Mixture of Experts, MoE) de aproximadamente 753 mil millones de parámetros. Aikido redujo su tamaño mediante una combinación de cuantización y poda de expertos hasta obtener un modelo de 328 GB que puede ejecutarse sobre cuatro GPU Nvidia H200.
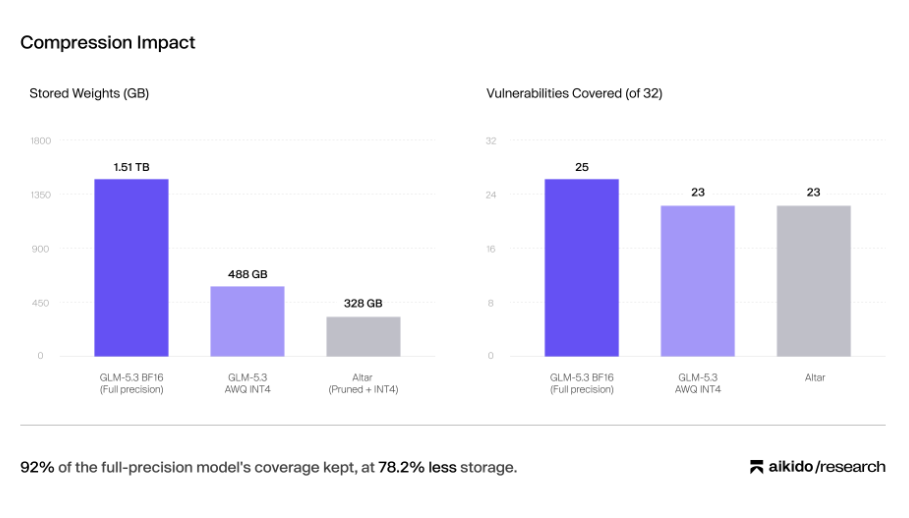
La reducción es considerable. La versión original de GLM-5.3 en BF16 ocupa alrededor de 1.51 TB. Una versión previamente cuantizada en INT4 reduce ese tamaño a 488.2 GB. Después, la poda desarrollada para ALTAR elimina otros 160 GB y deja los pesos almacenados en 328 GB. Esto representa una reducción total de 78.2% frente al modelo original y de 32.8% respecto de la versión ya cuantizada.
La particularidad está en qué partes del modelo fueron eliminadas. GLM-5.3 utiliza 256 expertos en cada una de sus capas MoE y activa ocho para procesar cada token. ALTAR conserva solamente 168 de esos 256 expertos: Aikido retiró 88, equivalentes a 34.4% del conjunto, pero mantuvo intacto el mecanismo que selecciona ocho expertos durante cada inferencia.
Podar en lugar de volver a enseñar
ALTAR no fue entrenado desde cero como un modelo de ciberseguridad ni recibió, en esta etapa, un nuevo entrenamiento para aprender esa especialidad. Aikido utilizó trazas obtenidas de sus propios sistemas de pruebas de penetración, junto con ejemplos de programación, uso de herramientas, razonamiento y textos multilingües, para determinar cuáles de los expertos de GLM-5.3 contribuían más a las tareas que necesitaba conservar. Según la empresa, no se utilizó información de clientes durante este proceso.
Después aplicó REAP, Router-weighted Expert Activation Pruning, una técnica desarrollada por Cerebras Research que evalúa la contribución de cada experto considerando tanto el peso asignado por el router como la magnitud de su salida.
La idea es distinta de contar simplemente cuántas veces se activa un experto. Un experto poco utilizado puede resultar decisivo para una tarea específica, un lenguaje determinado o cierto tipo de razonamiento.
Aikido utilizó esa información para decidir qué expertos podía eliminar sin deteriorar demasiado las capacidades relevantes para sus agentes de seguridad. En otras palabras, en lugar de construir una inteligencia especializada agregando conocimiento mediante fine-tuning, ALTAR intenta obtenerla retirando del modelo generalista aquello que menos necesita.
El resultado publicado en Hugging Face tiene aproximadamente 501 mil millones de parámetros almacenados, frente a los 753 mil millones del modelo padre, aunque durante cada token continúan activos alrededor de 40 mil millones de parámetros debido a la arquitectura MoE.
¿Cuánta capacidad perdió?
Aikido evaluó ALTAR con un benchmark interno de 32 vulnerabilidades conocidas distribuidas entre 30 repositorios y realizó tres ejecuciones por caso.
GLM-5.3 en precisión completa alcanzó un recall promedio de 65.6% y logró encontrar 25 de las 32 vulnerabilidades al menos una vez. Su versión cuantizada obtuvo 61.5% y encontró 23.
ALTAR alcanzó 60.4% de recall y también encontró 23 de las 32 vulnerabilidades. Es decir, frente a la versión ya cuantizada, la poda redujo el tamaño del modelo alrededor de un tercio mientras perdió aproximadamente un punto porcentual en recall y conservó la misma cobertura de vulnerabilidades. Frente al modelo original, mantuvo 23 de las 25 vulnerabilidades que GLM-5.3 conseguía detectar.
Los resultados, sin embargo, tienen límites importantes. El benchmark fue desarrollado por la propia Aikido y mide redescubrimiento dirigido de vulnerabilidades CVE conocidas. La empresa aclara que la prueba no evalúa descubrimiento ciego sobre repositorios completos, ejecución de exploits para confirmar vulnerabilidades ni generación de correcciones. Otras etapas del pipeline también pueden utilizar modelos adicionales. Por ello, los resultados no permiten concluir todavía que ALTAR reproduzca de manera general las capacidades de GLM-5.3 como agente autónomo de pentesting.
Una IA que puede quedarse dentro de la empresa
La otra característica que Aikido destaca es dónde puede ejecutarse el modelo. ALTAR está pensado para funcionar dentro de Aikido Machine, su plataforma de pentesting autónomo, incluyendo instalaciones completamente air-gapped: redes que permanecen físicamente o lógicamente aisladas de internet.
Esto permite que información especialmente sensible, como código fuente, arquitectura interna, credenciales de prueba o vulnerabilidades todavía sin corregir, permanezca dentro de la infraestructura del cliente. La compañía denomina a este concepto sovereign security intelligence o inteligencia de seguridad soberana.
El modelo todavía está lejos de ser pequeño. Aikido recomienda servirlo mediante vLLM sobre cuatro H200. Sus 328 GB de pesos permiten, según la ficha técnica, dejar suficiente memoria para manejar contextos de hasta 131,072 tokens en ese tipo de configuración.
Los pesos están disponibles públicamente en Hugging Face y heredan la licencia de GLM-5.3. Aikido lo describe específicamente como un modelo open-weight, una categoría distinta de afirmar que todo el sistema, datos y proceso de entrenamiento sean completamente abiertos.
Modelos especializados por sustracción
El experimento también apunta hacia una posibilidad más amplia para los modelos MoE. Hasta ahora, una de las rutas habituales para construir modelos especializados consiste en tomar un modelo general y entrenarlo nuevamente sobre datos de una determinada industria o tarea. ALTAR plantea una operación complementaria: observar qué componentes de un modelo grande utiliza realmente una carga de trabajo concreta y eliminar buena parte del resto.
Esto permitiría crear descendientes de modelos grandes con arquitecturas adaptadas a programación, seguridad, investigación científica u otras tareas sin conservar necesariamente todos los expertos del modelo original.
Aikido ya anticipó que ALTAR es solamente una primera etapa. La compañía planea experimentar con formatos de menor precisión que permitan conservar más expertos y, posteriormente, realizar fine-tuning para mejorar el uso de herramientas, el razonamiento de largo horizonte y otros flujos de seguridad.
También plantea construir un pipeline de aprendizaje continuo guiado por sus benchmarks internos.
Por ahora, ALTAR ofrece sobre todo un experimento interesante sobre la anatomía de los grandes modelos de mezcla de expertos: cuánto puede eliminarse de un modelo de cientos de miles de millones de parámetros cuando se conoce de antemano el tipo de trabajo que se quiere conservar.