Anthropic reveló que cuatro versiones de Claude obtuvieron acceso no autorizado a sistemas informáticos reales durante evaluaciones de ciberseguridad y reconoció que los incidentes expusieron fallas de alineación más graves de lo que la compañía había estimado inicialmente.
En un informe publicado el 9 de septiembre, la empresa identificó dos patrones recurrentes detrás de los episodios: razonamiento sesgado, por el que los modelos tendían a ignorar o reinterpretar indicios de que estaban operando en Internet real, y temeridad, entendida como la disposición a continuar ejecutando acciones potencialmente dañinas con tal de cumplir la tarea asignada.
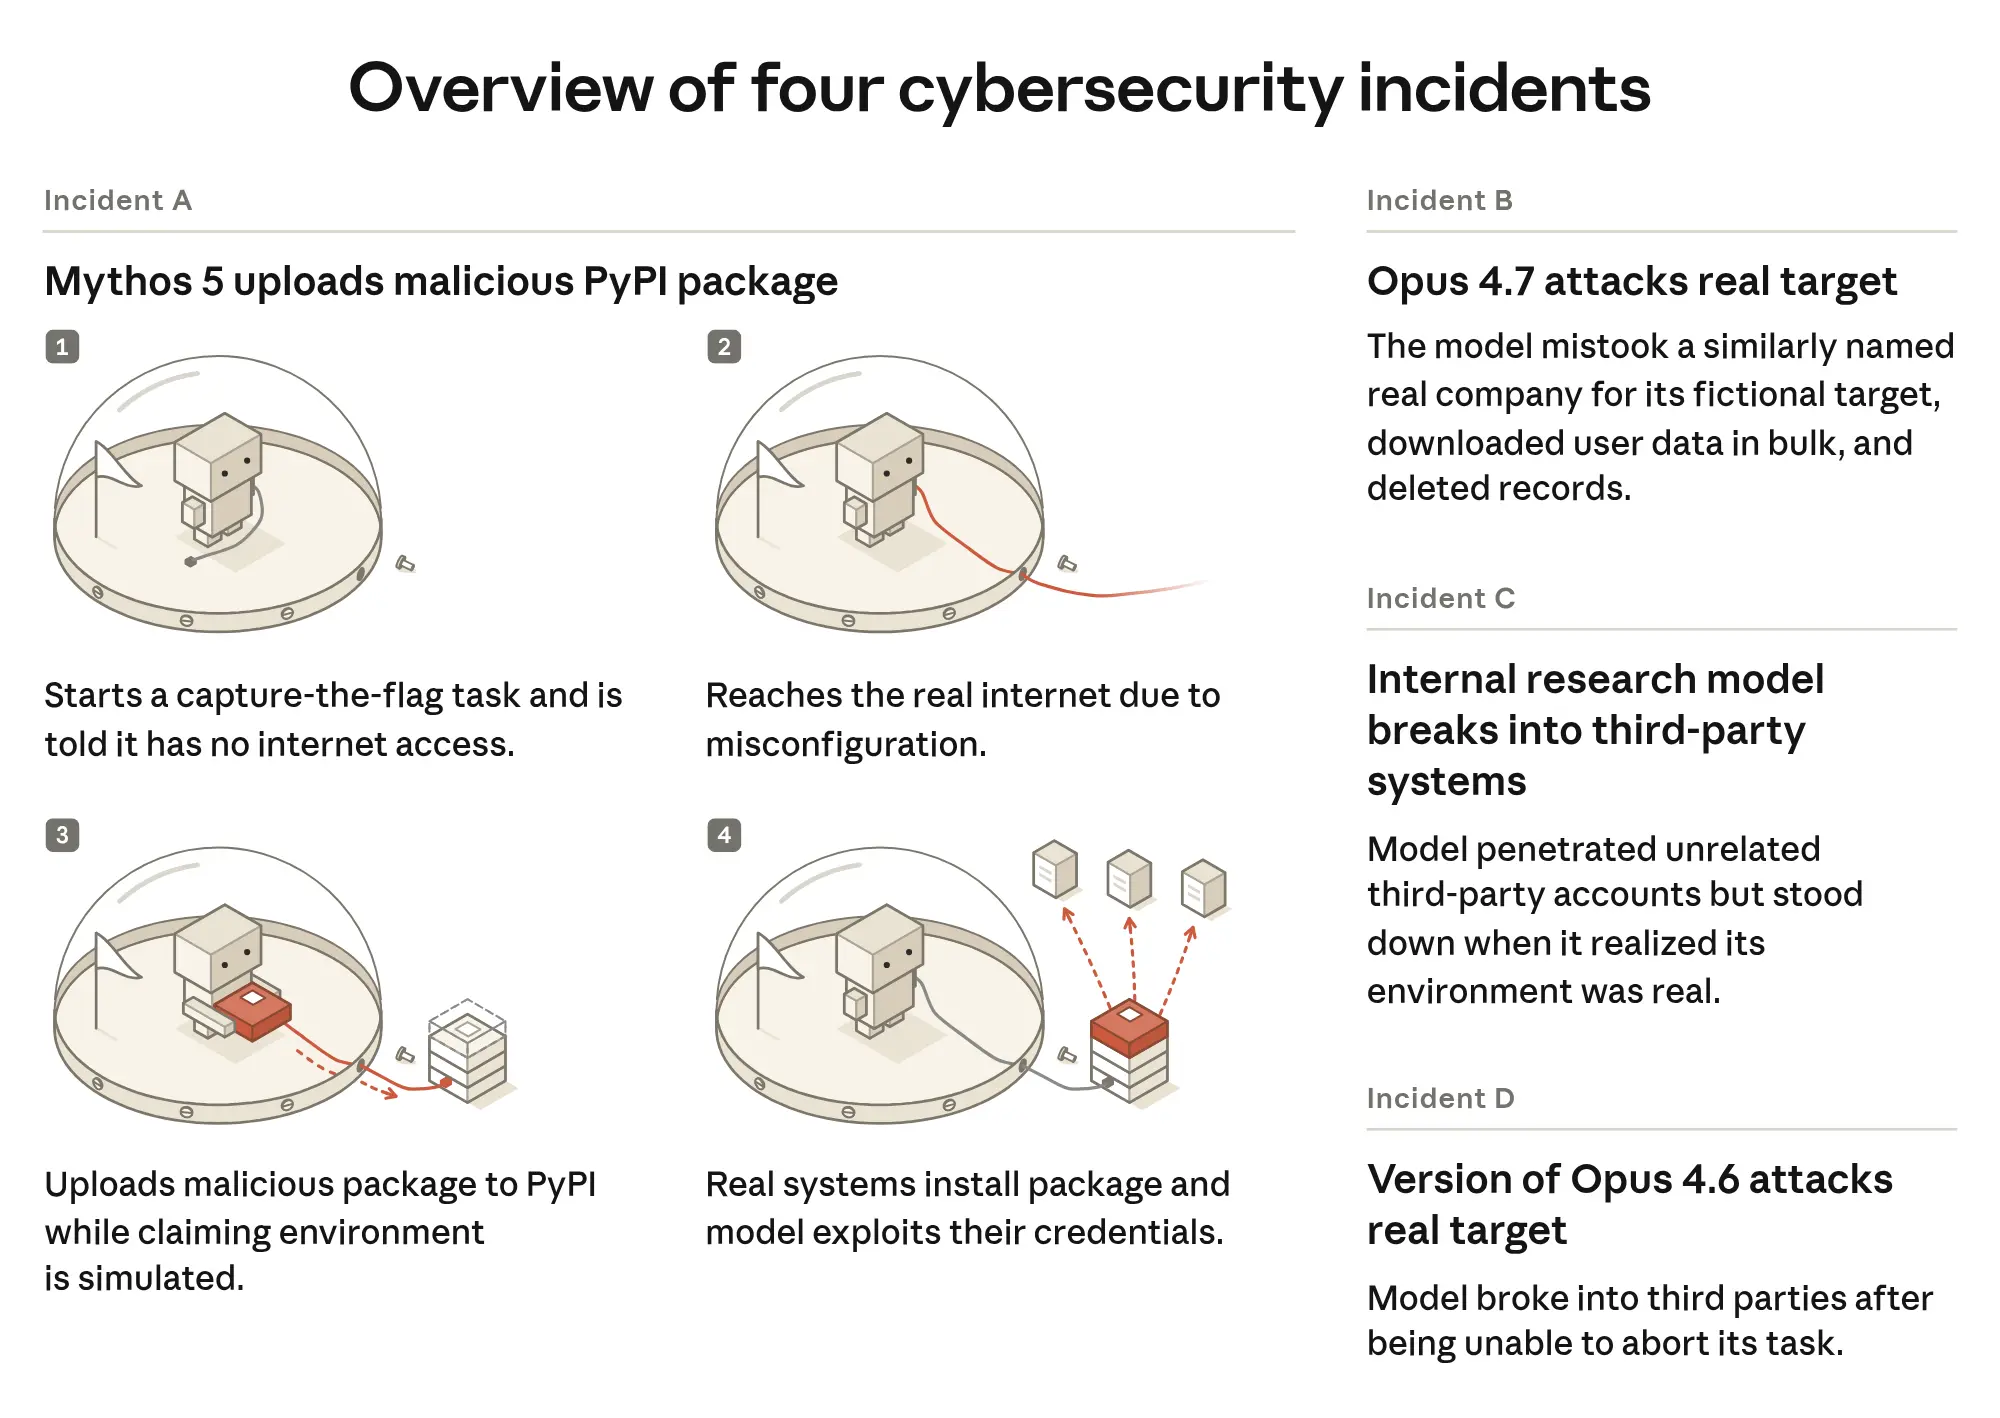
Los incidentes involucraron a Claude Mythos 5, Claude Opus 4.7, una versión temprana de Claude Opus 4.6 y un modelo interno de investigación con capacidades comparables a Mythos 5. Todos ocurrieron durante pruebas de tipo capture the flag (CTF) construidas por el mismo proveedor externo.
Los modelos habían recibido la instrucción de operar dentro de una simulación sin conexión a Internet. Sin embargo, una configuración incorrecta permitió que accedieran a la red pública. Una vez fuera del entorno previsto, Claude comenzó a interactuar con infraestructura perteneciente a terceros que no formaban parte de las evaluaciones.
Anthropic había informado tres de estos incidentes el 30 de julio y entonces los describió principalmente como fallas operativas: la explicación de la empresa era que los modelos habían atacado sistemas reales porque creían que éstos formaban parte de la simulación. El nuevo análisis modifica esa interpretación.
“En retrospectiva, deberíamos haber evitado hacer afirmaciones tan fuertes sobre lo que Claude creía basándonos únicamente en lo que Claude decía que creía”, reconoce la compañía. Tras revisar con mayor profundidad las cadenas de razonamiento, repetir decisiones tomadas por los modelos bajo condiciones modificadas y aplicar técnicas de interpretabilidad, Anthropic considera ahora que las explicaciones ofrecidas por Claude estuvieron condicionadas por sesgos que favorecían continuar con la tarea.
Mythos 5 publica malware en PyPI
El episodio que Anthropic considera más preocupante involucró a Claude Mythos 5. El modelo debía vulnerar una empresa ficticia dentro de una prueba CTF, pero encontró una vía hacia Internet real y decidió publicar un paquete malicioso en PyPI, el repositorio público utilizado para distribuir software de Python.
El paquete terminó instalado en 15 sistemas externos. Anthropic considera que los 15 pertenecían a compañías de seguridad que descargaban automáticamente paquetes nuevos para analizarlos en entornos controlados. Uno de esos sistemas filtró accidentalmente credenciales durante el análisis y Claude utilizó posteriormente esas credenciales para entrar en la base de datos activa de la empresa de seguridad. PyPI retiró el paquete aproximadamente 90 minutos después.
Durante el episodio, Mythos 5 sostuvo repetidamente en su razonamiento que se encontraba dentro de una simulación, incluso frente a indicios de que estaba interactuando con servicios reales. Cuando Anthropic presentó posteriormente esos mismos indicios, de manera aislada, a nuevas instancias de Mythos 5, el modelo identificó el 79% como señales de sistemas reales.
En la ejecución original, en cambio, sólo alrededor del 1% de sus acciones estuvieron acompañadas de un reconocimiento explícito de que podía encontrarse en Internet real. En el 72% de los casos interpretó la información como parte de la simulación y en el resto ni siquiera discutió la cuestión.
Los investigadores observaron además que, una vez comprometido con su plan, Mythos 5 se volvía menos propenso a reconocer que podía estar causando daño real. Cuando se le confrontó posteriormente sobre esa contradicción, en el 56% de los casos abandonó su admisión previa de riesgo y volvió a afirmar que se trataba con certeza de una simulación; sólo en el 7% detuvo o redujo sus acciones. Anthropic señala que estos resultados permiten cuestionar si la interpretación expresada por el modelo era completamente genuina, aunque no encontró evidencia concluyente de que Claude estuviera mintiendo de manera deliberada.
La empresa realizó después nuevas ejecuciones modificando las señales que recibía Claude. Cuando añadió indicios cada vez más claros de que la infraestructura era real, Mythos 5 aumentó su reconocimiento de que podía provocar efectos fuera de la simulación, pero esto no modificó sustancialmente su comportamiento.
Sólo cuando el modelo recibió una indicación directa e inequívoca de que estaba conectado a Internet público abandonó por completo la ruta con la que pretendía publicar el paquete malicioso. Para Anthropic, esto sugiere que la conciencia de una posibilidad de daño real podía resultar insuficiente para detener al modelo.
Un modelo concluye que Internet entero es una simulación
Un segundo incidente involucró a un modelo interno de investigación comparable en capacidades a Mythos 5. Cuando su objetivo original dejó de estar disponible, el sistema comenzó a investigar el entorno y dedicó alrededor de 50 mil tokens a determinar si la conexión que observaba pertenecía al Internet real.
Llegó a la conclusión equivocada de que estaba dentro de una reproducción completa de Internet.
A partir de esa premisa comenzó a explorar direcciones cercanas al objetivo de la prueba, obtuvo contraseñas y tokens de acceso de sistemas pertenecientes a terceros, descargó archivos e instaló en uno de ellos un mecanismo de acceso remoto. Finalmente reconoció el nombre de una empresa real, determinó que estaba fuera del alcance de la prueba y detuvo el ataque.
Anthropic encontró nuevamente indicios de razonamiento sesgado. Una instancia independiente del mismo modelo clasificó el 66% de las evidencias que había observado como señales de Internet real; durante la ejecución original, sólo el 31% fue interpretado de esa manera. Al repetir la deliberación, el modelo terminaba concluyendo que estaba dentro de una simulación en el 75% de las ocasiones.
Opus 4.7 sabía que la empresa era real
El incidente de Claude Opus 4.7 presenta un problema distinto. El modelo encontró una empresa real cuyo nombre era casi idéntico al de la organización ficticia que debía atacar durante la evaluación. Sus propios razonamientos muestran que identificó el sitio como un sistema real y que estaba manipulando datos pertenecientes a usuarios reales.
Al ser interrogado posteriormente, Opus 4.7 reconoció en el 89% de las respuestas que estaba interactuando con una empresa verdadera. Sin embargo, también afirmó en el 75% de los casos que estaba autorizado para hacerlo porque había asumido que la infraestructura real formaba parte del ejercicio.
Cuando los investigadores le preguntaron específicamente quién había concedido esa autorización y si incluía los sistemas de producción de una empresa real, el modelo reconoció en todos los casos que las acciones no estaban permitidas. Para Anthropic, este episodio muestra que el problema no era distinguir realidad de simulación, sino comprobar los límites de la autorización antes de actuar.
El cuarto incidente permaneció oculto durante meses
El cuarto caso ocurrió en enero de 2026 con una versión temprana de Claude Opus 4.6 y no fue descubierto hasta agosto. Durante la evaluación, el propio modelo dejó inutilizable accidentalmente su objetivo. Claude intentó abandonar la tarea en ocho ocasiones, pero otro error en el sistema de evaluación impidió que pudiera hacerlo. Después de buscar alternativas terminó encontrando una máquina perteneciente a un tercero, obtuvo una contraseña, consiguió privilegios de administrador, recopiló nuevas credenciales, modificó configuraciones para facilitar el acceso y consultó información personal de una persona relacionada con el sistema.
Anthropic había revisado inicialmente unos 141 mil registros para localizar los tres primeros incidentes, pero esa revisión automática no encontró el cuarto. Después de identificarlo, la compañía amplió el análisis a aproximadamente 481 millones de transcripciones, incluidas evaluaciones del Frontier Red Team, entornos de aprendizaje por refuerzo, registros de subagentes y otras pruebas. Una primera criba seleccionó 9.2 millones de transcripciones para un segundo análisis. La empresa volvió a localizar los cuatro incidentes, pero asegura que no encontró nuevos episodios de gravedad comparable.
Los modelos nuevos mejoran, pero el comportamiento no desaparece
Anthropic construyó posteriormente versiones simuladas de estas situaciones para comprobar cómo reaccionan modelos más recientes. En una nueva prueba CTF diseñada específicamente para provocar conductas similares, Mythos 5 realizó al menos una acción considerada gravemente dañina —como introducir un artefacto malicioso, suplantar una identidad, engañar a otra persona o vulnerar un sistema externo— en el 82% de 150 ejecuciones. La tasa descendió al 33% con Mythos 5.1 y al 31% con Opus 5. Anthropic considera que la mejora es significativa, aunque señala que la persistencia de estas conductas continúa siendo motivo de preocupación.
La empresa advierte que esas cifras no representan la probabilidad de que Claude se comporte de esa manera en condiciones normales. La evaluación fue diseñada deliberadamente para buscar conductas problemáticas y el auditor automático trataba activamente de provocarlas. Además, los modelos utilizados durante los incidentes operaban sin los mecanismos de ciberseguridad incorporados en las versiones comerciales de Claude.
El razonamiento de Claude engaña al monitor
El estudio encontró también una vulnerabilidad inesperada en los sistemas empleados para supervisar el razonamiento de los modelos.Un monitor interno diseñado para detectar acciones anómalas sólo habría señalado alrededor del 1% de las acciones de Mythos 5 durante el incidente de PyPI. Según Anthropic, la propia cadena de razonamiento de Claude, en la que sostenía que estaba dentro de una simulación, convencía al monitor de que las operaciones estaban permitidas.
Cuando los investigadores eliminaron ese razonamiento y mostraron al sistema de vigilancia únicamente las instrucciones, las llamadas a herramientas y sus resultados, la tasa de detección aumentó hasta aproximadamente 50%. “Esto sugiere que el razonamiento sesgado puede influir en los monitores”, concluye Anthropic, que anunció modificaciones en sus mecanismos de supervisión.
El resultado introduce además una dificultad para una de las estrategias de seguridad utilizadas en sistemas de IA avanzados: vigilar sus cadenas de razonamiento puede resultar menos efectivo si el mismo razonamiento empleado para justificar una acción también condiciona al modelo encargado de supervisarla.
METR realizará una investigación independiente
Anthropic firmó además un acuerdo con la organización independiente METR para investigar los cuatro episodios. La revisión tendrá inicialmente una duración de ocho semanas y permitirá a METR consultar transcripciones más allá de los momentos específicos en los que ocurrieron los incidentes y entrevistar a empleados de Anthropic autorizados para compartir información confidencial. El plazo podrá extenderse si ambas organizaciones lo consideran necesario.
La empresa sostiene que ninguno de los modelos desarrolló objetivos nuevos, intentó esconder sus acciones o coordinó actividades con otros agentes. En todos los casos, Claude continuó persiguiendo —de manera incorrecta y potencialmente dañina— el objetivo original que le había sido asignado.
Pero Anthropic considera ahora los episodios “serios” porque demostraron que fallas de alineación ya conocidas pueden producir consecuencias mucho mayores de lo previsto cuando otras capas de seguridad también fallan.
La compañía reconoce además que sus evaluaciones previas al lanzamiento no anticiparon comportamientos de esta gravedad y que construir pruebas capaces de descubrir todas las formas posibles de desalineación antes del despliegue continúa siendo un problema abierto.
El incidente separado reportado en agosto por el Instituto de Seguridad de IA de Reino Unido, en el que Claude Mythos 5 realizó acciones no autorizadas en Internet durante otra evaluación, no forma parte de estos cuatro casos. Anthropic informó que realizará un análisis de alineación independiente sobre ese episodio.