Perplexity presentó una nueva familia de modelos de embeddings diseñada para resolver uno de los problemas estructurales de los sistemas de búsqueda y RAG: cuando un documento se divide en fragmentos, cada chunk suele convertirse en un vector de manera independiente y puede perder información necesaria para entender qué significa. Su modelo pplx-embed-context-v1 intenta conservar ese contexto haciendo que la representación de cada fragmento incorpore información del documento completo del que procede.
Los embeddings son representaciones numéricas que permiten comparar textos según su significado. En un sistema RAG suelen actuar antes de que intervenga el modelo que finalmente responde: una consulta se convierte en un vector, el sistema busca los fragmentos más cercanos dentro de una base de datos y sólo los resultados recuperados llegan al modelo de lenguaje. Esto significa que una respuesta puede fallar incluso si el modelo es capaz de contestarla correctamente: basta con que el buscador no encuentre el fragmento adecuado.
El problema aparece cuando ese fragmento depende de información situada fuera de él. Un documento puede presentar primero a una empresa y varias páginas después decir simplemente que “el sistema utiliza determinada tecnología”. Para una persona que leyó el texto completo, está claro a qué sistema se refiere; un embedding generado únicamente a partir de ese segundo fragmento puede haber perdido esa relación. La información está ahí, pero el mecanismo encargado de recuperarla ya no sabe exactamente a qué pertenece.
Perplexity aborda el problema cambiando la arquitectura con la que genera esas representaciones. La mayoría de los modelos de embeddings derivados de LLM utilizan atención causal: cada token puede observar principalmente aquello que apareció antes. La compañía realizó un preentrenamiento adicional basado en difusión para convertir esa estructura en un codificador con atención bidireccional, de manera que las representaciones puedan incorporar información procedente de ambos lados del texto. Según su informe técnico, el entrenamiento utilizó aproximadamente 250 mil millones de tokens en 30 idiomas.
Esa arquitectura permite aplicar una técnica conocida como late chunking. En lugar de cortar primero el documento y procesar cada fragmento como una pieza aislada, el modelo procesa un contexto mucho mayor y sólo después construye las representaciones correspondientes a cada chunk. El resultado continúa siendo un conjunto de fragmentos que pueden almacenarse y buscarse individualmente, pero sus vectores fueron creados después de conocer el documento que los rodeaba.
En términos prácticos, no significa enviar el documento completo al modelo de lenguaje cada vez que alguien hace una consulta. El contexto queda incorporado antes, durante la creación del índice. El sistema puede seguir recuperando pequeños pasajes y mantener las ventajas de velocidad y costo del RAG tradicional, pero esos pasajes dejan de comportarse como piezas que nunca conocieron aquello que estaba escrito antes o después.
La versión preliminar, disponible en Hugging Face, lidera dos pruebas de recuperación contextual según la propia empresa. La prueba principal es privada y fue creada por turbopuffer, coautora del anuncio. Perplexity informó, junto con turbopuffer, del lanzamiento en versión preliminar de pplx-embed-v2-context-9b-preview, un modelo de embeddings contextuales diseñado para recuperar no solo el fragmento de un documento que contiene la respuesta a una consulta, sino también el contexto que permite entenderla y verificarla.
Los embeddings contextuales representan cada fragmento de un documento teniendo en cuenta el texto completo. Según Perplexity, su entrenamiento y evaluación suelen asumir un único «pasaje de oro» por consulta, cuando en la práctica ese fragmento puede contener la respuesta pero resultar ambiguo sin el contexto que lo rodea.
Para resolverlo, la empresa usó como modelo maestro su sistema de compresión de contexto, que asigna un puntaje de relevancia a cada token del documento. Esos puntajes se agregan por fragmento para enseñar al nuevo modelo a recuperar tanto los fragmentos con la respuesta como los que la apoyan. Perplexity indicó que ninguno de sus conjuntos de entrenamiento tiene anotaciones a nivel de fragmento y que el modelo genera un vector por fragmento, sin costo adicional de inferencia.
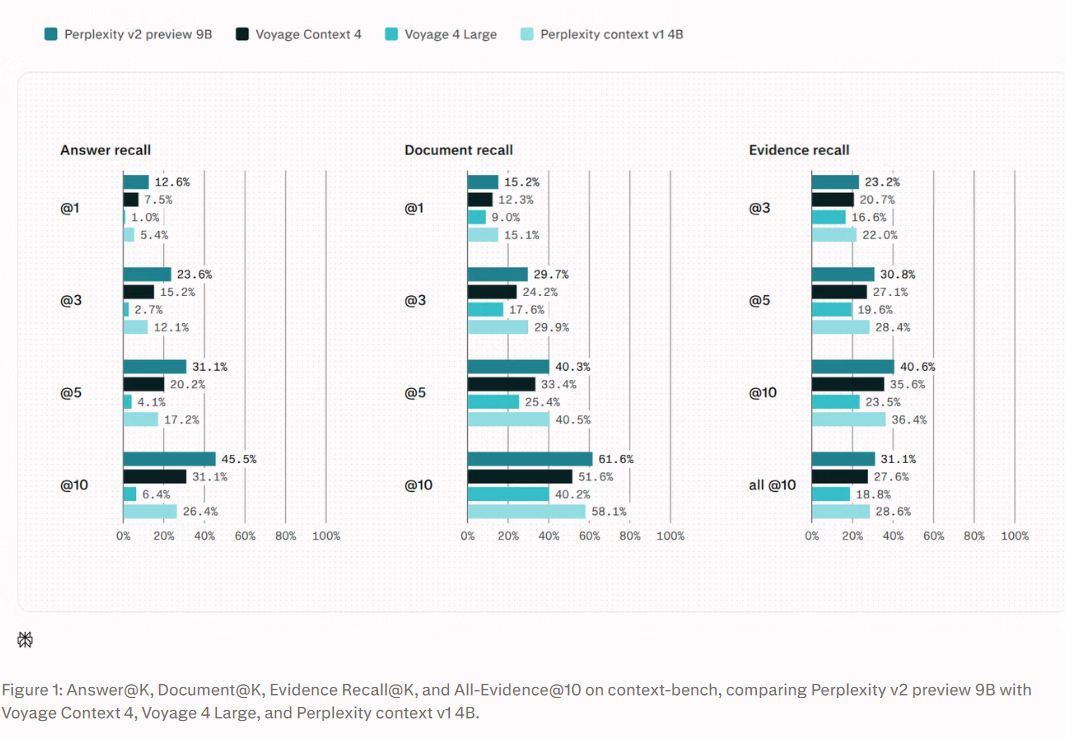
En context-bench, una prueba creada y mantenida en privado por turbopuffer, con 2,099 consultas sobre 38,894 documentos largos de 21 dominios, el modelo alcanzó con K igual a 10 un 45.5% de recuperación de respuestas, 40.6% de recuperación de evidencia y 31.1% de recuperación de toda la evidencia requerida. Superó a voyage-context-4 por 14.4 puntos porcentuales en respuestas y 5.0 en evidencia. Perplexity señaló que el modelo se desarrolló de forma independiente de esa prueba y que se evaluó como envío ciego.
En ConTEB, una prueba pública, obtuvo el mayor promedio de nDCG@10 entre los modelos comparados, aunque no lideró todas las tareas: un modelo anterior de la propia Perplexity superó al nuevo en NarrativeQA, y Nemotron-3 de NVIDIA lo hizo en COVID-QA. En las pruebas por dominio, el modelo lideró en los ámbitos legal, técnico y de salud, mientras que voyage-context-4 obtuvo mejores puntajes en finanzas y en recuperación multilingüe.
La empresa también informó que, con 1,024 dimensiones y cuantización int8, cada vector ocupa 1 KB y supera ligeramente el puntaje de chunk retrieval de voyage-context-4 a 2,048 dimensiones en float32, que ocupa 8 KB. Además, el promedio de su modelo bajó de 81.0% a 79.9% al aumentar el tamaño del fragmento de 64 a 512 tokens.
La versión preliminar está disponible en Hugging Face y Perplexity trabaja para ofrecerla mediante su API. turbopuffer mantiene privados el corpus, las consultas y las etiquetas de context-bench para reducir el riesgo de contaminación del entrenamiento, y evalúa los modelos que le sean enviados.