Un estudio de la UNAM advirtió desde 2023 problemas de interoperabilidad, pérdida de metadatos y falta de documentación en los repositorios culturales mexicanos. En 2026, mientras especialistas iberoamericanos discuten inteligencia artificial y soberanía tecnológica, el acceso a algunos acervos del INAH continúa siendo irregular.
México reunió esta semana a especialistas de 11 países para discutir cómo incorporar inteligencia artificial a la preservación de archivos sonoros, fotográficos, audiovisuales y textuales. Durante tres días se habló de sesgos, soberanía tecnológica, derechos de autor, multiculturalidad y nuevas herramientas para catalogar y recuperar patrimonio documental. Sin embargo, el encuentro ocurre mientras el país todavía arrastra problemas mucho más elementales en su infraestructura digital: repositorios fragmentados, modelos de metadatos que no siempre son compatibles, migraciones prolongadas y fallas de acceso a colecciones que ya habían sido digitalizadas.
El II Encuentro Iberoamericano de Archivos: Inteligencia Artificial en la Preservación Documental, organizado en la Fonoteca Nacional del 7 al 9 de septiembre, fue presentado por la Secretaría de Cultura como un espacio para construir respuestas propias ante la incorporación de IA en los archivos y fortalecer el acceso responsable al patrimonio documental. La dependencia planteó incluso la necesidad de preservar la memoria con “ética y soberanía” frente a tecnologías desarrolladas principalmente fuera de la región.
Pero el programa oficial estuvo estructurado principalmente como un espacio de reflexión, conferencias y talleres. El último día incluyó una conferencia sobre gobernanza, sesgos y soberanía tecnológica, una mesa sobre género y multiculturalidad y talleres sobre inclusión y derechos de autor. La sesión de cierre estuvo destinada a la entrega de reconocimientos y clausura. Hasta este 9 de septiembre no se ha publicado una declaración final, un estándar común, un protocolo de adopción de inteligencia artificial ni un calendario de trabajo derivado del encuentro. La ausencia de una hoja de ruta resulta especialmente llamativa porque varios de los problemas previos a la adopción de IA ya habían sido identificados académicamente.
El problema estaba documentado desde 2023
En 2023, Claudio Molina Salinas, investigador del Instituto de Investigaciones Estéticas de la UNAM, publicó en Cuadernos.info el estudio Desafíos de la preservación digital del patrimonio cultural en México: El caso de Mexicana. El trabajo analizó cómo circulaba la información entre distintos repositorios culturales mexicanos y utilizó como caso la Piedra del Sol para comparar sus registros en la Mediateca del INAH y Mexicana, el repositorio de patrimonio cultural creado por la Secretaría de Cultura.
El estudio encontró que México ya había avanzado en normalización y adopción de estándares internacionales de metadatos, pero señaló un problema de fondo: la información no atraviesa intacta los distintos sistemas. Los datos pueden originarse en un museo, pasar después a la Mediateca del INAH y finalmente ser cosechados por Mexicana. En cada transferencia existe un “tamiz de información” provocado por las diferencias entre modelos de datos, por lo que parte de la riqueza descriptiva puede desaparecer.
El problema no consiste únicamente en que existan varias bases de datos. La redundancia puede ser positiva: disponer de varias copias de un mismo objeto digital protege el patrimonio ante incendios, inundaciones, sismos o fallas técnicas. El propio estudio recuerda que el servidor de la Mediateca se encontraba en el Conjunto Aristos durante el terremoto de 2017 y que la información pudo conservarse gracias a respaldos y a la recuperación posterior del sistema.
El desafío está en conseguir que esas copias puedan comunicarse entre sí y seguir siendo accesibles durante cambios de plataforma. Molina Salinas sostiene que la preservación digital debe entenderse como una política que garantice acceso continuo pese a migraciones, actualizaciones y obsolescencia tecnológica, no únicamente como la conservación de archivos en distintos servidores. Ese punto resulta particularmente relevante tres años después.
Una Mediateca “en transformación”
La antigua Mediateca del INAH lleva un proceso prolongado de sustitución por un nuevo Repositorio Institucional. Un aviso todavía indexado por buscadores explica que la plataforma se encuentra “en transformación” y afirma que sus colecciones fueron trasladadas al nuevo repositorio. Otras páginas antiguas quedaron durante meses mostrando avisos de mantenimiento.
Un aviso institucional difundido desde 2025 llegó a informar simultáneamente que las páginas de Mediateca INAH y Lugares INAH se encontraban en mantenimiento. Actualmente el nuevo Repositorio Institucional sí contiene materiales procedentes de la Fototeca Nacional y otros acervos. Por ejemplo, existen nuevamente fichas de la Colección Archivo Casasola con imagen, autoría, fecha, técnica, procedencia, identificadores y metadatos en formatos MODS y Dublin Core.
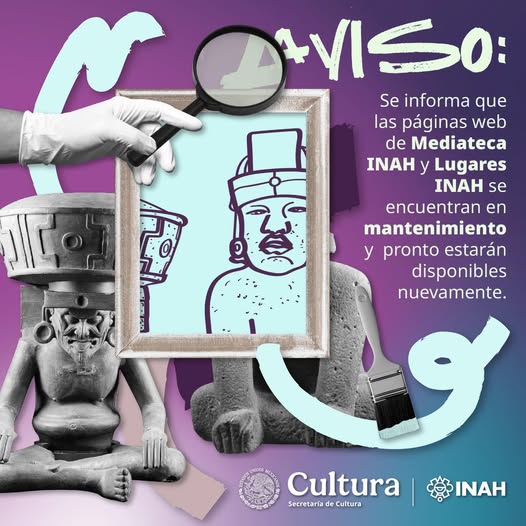
Sin embargo, el acceso no es estable en todas las rutas. En pruebas realizadas este 9 de septiembre, usuarios recibieron respuestas 429 Too Many Requests al intentar navegar por algunos acervos, mientras consultas directas a las páginas principales de la Mediateca y el nuevo Repositorio INAH agotaron el tiempo de respuesta. Al mismo tiempo, fichas individuales permanecen indexadas y algunas pueden abrirse normalmente.
Eso obliga a distinguir entre pérdida del patrimonio y pérdida de acceso. No hay evidencia de que las colecciones hayan desaparecido: el nuevo repositorio conserva numerosos objetos y el INAH afirma que los contenidos de la antigua Mediateca fueron migrados. El problema es que una colección digital puede estar preservada físicamente y, al mismo tiempo, resultar difícil o imposible de consultar durante determinados periodos. Para un repositorio público, esa diferencia no es menor.
Antes de entrenar una IA hay que ordenar los datos
El estudio de 2023 proponía acciones que resultan sorprendentemente actuales: realizar un diagnóstico integral sobre cómo museos y organismos de Cultura gestionan sus acervos; conocer con qué personal e infraestructura cuentan; formar una comunidad permanente de trabajo; homogeneizar estructuras de datos; consensuar procedimientos; normalizar vocabularios y mejorar la interoperabilidad entre repositorios.
También señalaba un problema de transparencia técnica: el investigador encontró poca documentación pública sobre las decisiones adoptadas para construir los distintos repositorios mexicanos, sus metodologías y sus modelos de información, y recomendó que esa documentación fuera publicada incluso dentro de los propios sistemas.
Son precisamente esos cimientos los que adquieren mayor importancia cuando entra la inteligencia artificial. Un modelo puede transcribir miles de horas de audio, describir fotografías, identificar objetos, traducir documentos o generar automáticamente metadatos. Pero para que esas operaciones puedan utilizarse entre instituciones es necesario saber previamente cómo se representa una persona, una fecha, un lugar, una obra, un autor o una colección en cada sistema.
Si una institución utiliza el campo “autor”, otra “creador”, otra “fotógrafo” y una cuarta utiliza vocabularios diferentes para nombrar lugares, periodos históricos o técnicas, una IA no elimina automáticamente el problema. En determinadas condiciones puede simplemente automatizar y multiplicar el desorden existente. Además, si los resultados generados por un modelo pasan posteriormente de un repositorio a otro mediante estructuras incompatibles, vuelve a producirse el mismo “tamiz de información” que ya documentaba el estudio de la UNAM.
IA sobre una infraestructura todavía inconclusa
El encuentro celebrado esta semana sí abordó problemas futuros importantes. Hubo talleres sobre utilización de IA para archivos, identificación automática de fallas de audio, creación de catálogos de experiencias, diseño de procesos inclusivos y derechos de autor.
Pero no aparece todavía una decisión común sobre cuestiones más básicas que podrían comenzar a resolverse independientemente del desarrollo de nuevos modelos: un inventario interoperable de acervos digitales, un conjunto mínimo de metadatos compartidos, identificadores persistentes, procedimientos documentados de migración, sistemas públicos para informar interrupciones o una política común de trazabilidad que permita saber cuándo una descripción fue creada por una persona y cuándo por una IA.
La Secretaría de Cultura sostiene que los resultados de la agenda iberoamericana desarrollada durante septiembre y octubre alimentarán la XXX Cumbre Iberoamericana, prevista para noviembre en Madrid. Eso deja abierta la posibilidad de que las discusiones de esta semana se conviertan después en propuestas concretas.
Por ahora, sin embargo, la distancia entre la conversación y la infraestructura resulta evidente.
México tiene algunas de las colecciones documentales más importantes de América Latina repartidas entre instituciones como el INAH, el Archivo General de la Nación, la UNAM, la Fonoteca Nacional, el INBAL y la Cineteca Nacional. Una parte sustancial ya ha sido digitalizada, pero el desafío no termina al escanear una fotografía o convertir una cinta en un archivo digital.
Preservar implica también poder encontrarlo después. Y ésa puede ser la contradicción central de la discusión actual: antes de preguntarse qué inteligencia artificial debe interpretar la memoria mexicana, las instituciones todavía tienen pendiente garantizar que sus propios sistemas puedan conservarla, describirla conjuntamente y mantenerla accesible.