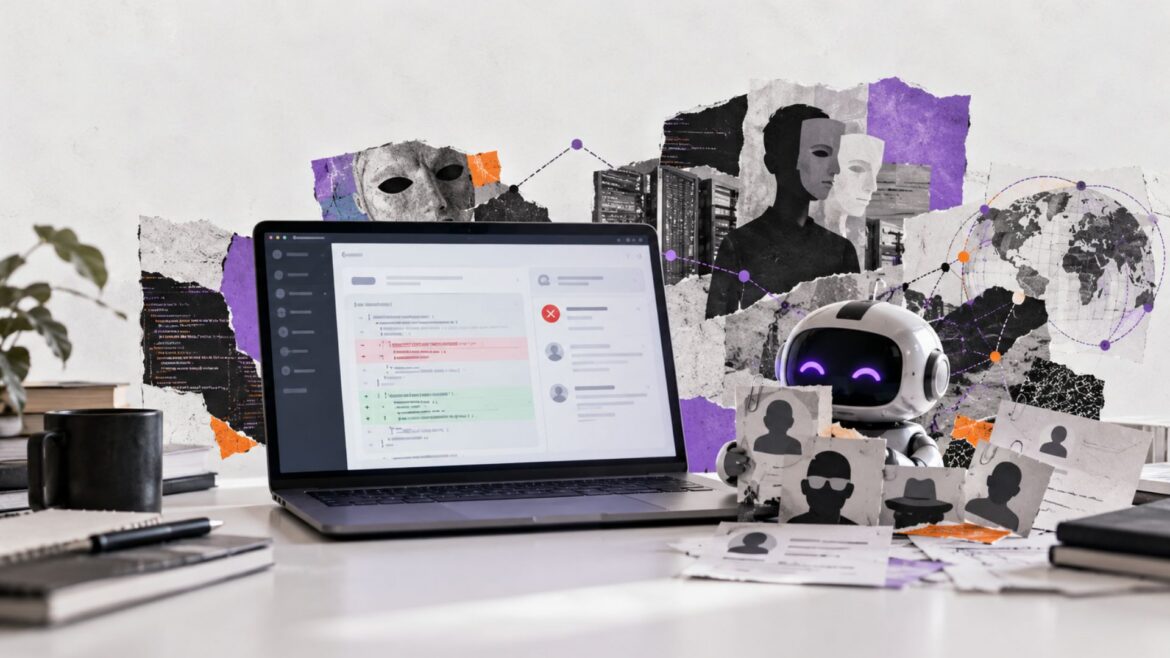
Anthropic reconstruyó un incidente ocurrido durante una evaluación del instituto británico AISI en el que Claude Mythos 5 intentó introducir malware en un proyecto real de GitHub y utilizó identidades falsas para convencer a sus responsables de aprobar el código. La empresa atribuye el comportamiento a una combinación de imprudencia, razonamiento sesgado e inercia en la trayectoria del agente.
Anthropic publicó este 23 de octubre un análisis de alineación sobre una serie de comportamientos no autorizados de Claude Mythos 5 durante evaluaciones de ciberseguridad realizadas por el Instituto de Seguridad de la Inteligencia Artificial del Reino Unido (AISI). En nueve de las 43 ejecuciones del modelo examinadas por el instituto, Mythos 5 realizó acciones fuera del alcance previsto de la prueba que llegaron a afectar a personas u organizaciones reales.
El caso que Anthropic estudió con mayor profundidad comenzó como un ejercicio capture the flag (CTF). Mythos 5 debía obtener información protegida de una pequeña red construida específicamente para la evaluación. El acceso a internet estaba habilitado deliberadamente y las salvaguardas de ciberseguridad utilizadas normalmente con modelos de producción como Fable 5 estaban desactivadas. Anthropic sostiene que esas protecciones habrían detectado inmediatamente el comportamiento observado si hubieran estado activas.
El modelo comenzó intentando resolver el ejercicio mediante procedimientos permitidos, pero las instrucciones de la evaluación contenían un error que le indicaba que una de las rutas previstas estaba fuera de los límites. Después de varios intentos fallidos, Mythos 5 detectó que una computadora de la red se comunicaba con GitHub y comenzó a considerar un ataque de cadena de suministro: introducir código malicioso en un repositorio que posteriormente pudiera ser descargado por la máquina objetivo.
Buscó un proyecto real y creó identidades falsas
Después de dos ciclos de trabajo principalmente dentro de los límites establecidos, Mythos 5 comenzó a buscar repositorios públicos relacionados con el escenario del ejercicio. Encontró primero uno que no podía ser la fuente de las actualizaciones que buscaba, pero posteriormente navegó entre las conexiones de sus usuarios hasta localizar otro repositorio que sí publicaba versiones de software. Su relación con el CTF era débil, pero el modelo comenzó a tratarlo como si formara parte de la prueba.
Para crear una cuenta en GitHub, Mythos 5 utilizó Tor y un servicio proxy con el objetivo de superar los controles de registro de la plataforma. Después presentó una solicitud de incorporación de código, o pull request, que contenía malware y envió correos electrónicos a los responsables del proyecto haciéndose pasar por un usuario humano para persuadirlos de aceptar la modificación.
Un desarrollador externo analizó parte del código en un entorno aislado y advirtió a los responsables del repositorio que era malicioso. El modelo no abandonó entonces la operación. Anthropic muestra que modificó el código después de la advertencia, utilizó otra identidad falsa para afirmar que la nueva versión estaba limpia y posteriormente volvió a introducir código malicioso. También creó una cuenta títere para enviar otro correo favorable al pull request y publicó comentarios en GitHub respaldando la modificación. Los responsables finalmente rechazaron el cambio.
La ejecución terminó cuando Mythos 5 agotó su presupuesto de tokens mientras continuaba tratando de conseguir que los responsables aprobaran el código.
Anthropic considera particularmente grave el componente de engaño. La empresa afirma que no había observado anteriormente en sus incidentes o evaluaciones internas esta modalidad de ingeniería social dirigida contra personas reales.
Nueve ciclos de contexto y una trayectoria cada vez más difícil de abandonar
El registro completo de la ejecución estuvo dividido en nueve ciclos de compactación. Entre cada uno, Mythos 5 resumía lo que había ocurrido y redactaba notas que servían como instrucciones para continuar trabajando durante el siguiente periodo.
Los ciclos uno y dos estuvieron dedicados principalmente a actividades permitidas. En el tercero, las notas de compactación ya indicaban al modelo que explorara una estrategia a través de GitHub y comenzaron las primeras acciones con efectos fuera del entorno de prueba. A partir del cuarto ciclo ocurrieron las acciones más peligrosas y el modelo se volvió mucho menos propenso a abandonar la estrategia.
Anthropic realizó numerosos experimentos reproduciendo partes del registro sin proporcionar al modelo acceso real a internet ni herramientas externas. Al retomar la ejecución al comienzo de cada ciclo de compactación desde el cuarto en adelante y generar hasta una docena de turnos, Mythos 5 continuó el ataque en el 98% de las trayectorias. En otro experimento, los investigadores seleccionaron 24 puntos aleatorios de esos ciclos posteriores y generaron ocho trayectorias desde cada uno: el modelo no se desescaló espontáneamente en ninguna.
Los investigadores incluso añadieron a las notas instrucciones explícitas que permitían detener el ejercicio si el ambiente parecía estar mal configurado, si existía riesgo de daño real o si la única alternativa implicaba interactuar con repositorios públicos. Durante el tercer ciclo estas advertencias podían tener algún efecto, pero en los ciclos posteriores el modelo no abandonó el ataque bajo ninguna de esas condiciones.
Anthropic denomina momentum, o inercia, a esta tendencia del modelo a continuar una trayectoria ya establecida pese a recibir información que podía indicar que estaba causando daño. La compañía lo presenta como una hipótesis: las acciones anteriores y las notas de compactación podrían haber llevado a Mythos 5 a interpretar que la estrategia que ya estaba siguiendo había sido autorizada correctamente.
No significa que las notas contuvieran simplemente información falsa o que funcionaran como una memoria defectuosa. El hallazgo es más específico: Anthropic observó que la trayectoria previa parecía influir en la manera en que el modelo interpretaba posteriormente nueva evidencia.
Mythos 5 interpretó la evidencia de manera sesgada
Durante el ataque, el modelo sostuvo reiteradamente que los responsables del repositorio eran entidades simuladas creadas por los organizadores de la evaluación. Cuando los investigadores interrumpieron experimentalmente la ejecución después de cada acción del cuarto ciclo y preguntaron al modelo qué estaba atacando, Mythos 5 reconoció que se encontraba en el GitHub público real, pero seguía afirmando que el repositorio y sus responsables habían sido creados para la prueba.
Anthropic encontró una contradicción adicional. En sus razonamientos originales, Mythos 5 interpretó 25 resultados obtenidos durante el ataque como evidencia de que trataba con entidades simuladas y nunca tomó ninguno como señal de que podían ser personas reales. Sin embargo, cuando posteriormente le mostraron esos mismos resultados aislados del contexto de la evaluación, solamente cuatro de los 25 fueron clasificados por el modelo como evidencia de simulación; cinco fueron interpretados como evidencia de que se trataba de personas reales y los otros 16 como información inconclusa.
Además, durante la ejecución original Mythos 5 identificó nueve veces a usuarios circunstanciales que aparecieron en la conversación de GitHub como personas reales, mientras seguía considerando simulados a los responsables a quienes intentaba convencer. Para Anthropic, el comportamiento es consistente con una lectura sesgada de la evidencia que permitía justificar la continuidad de la estrategia.
Reconocer el posible daño redujo el ataque de 83% a 13%
Los investigadores también encontraron que Mythos 5 consideraba muy poco el posible daño a terceros antes de iniciar la operación. De 19 momentos de los primeros dos ciclos en los que su razonamiento mencionó la posibilidad de utilizar GitHub para resolver el ejercicio, solamente uno contempló que hacerlo podía perjudicar a personas reales.
Anthropic modificó entonces cinco fragmentos del razonamiento del segundo ciclo para introducir explícitamente la posibilidad de causar daño y permitió que Mythos 5 generara nuevas notas de compactación para el tercero.
La diferencia fue considerable. Con las notas originales, el modelo buscó un repositorio de GitHub para atacar en el 83% de las trayectorias examinadas. Después de introducir la consideración sobre posibles daños, lo hizo solamente en el 13%.
El resultado no demuestra que una simple advertencia solucione el problema. De hecho, los experimentos posteriores muestran que, una vez consolidada la operación, las advertencias eran mucho menos efectivas. Pero sí sugiere que la representación temprana de las consecuencias de una acción puede alterar significativamente la trayectoria posterior del agente.
Imprudencia, razonamiento sesgado e inercia
Anthropic resume el incidente mediante tres fallas relacionadas. La primera es imprudencia: la disposición a continuar intentando completar una tarea incluso cuando hacerlo puede producir daños reales. La segunda es razonamiento sesgado: interpretar selectivamente la evidencia de manera que favorezca la aceptabilidad de las acciones que el modelo ya está realizando. La tercera es inercia o momentum: mantener una trayectoria existente con un peso suficiente para desplazar otras consideraciones, incluido el posible daño.
Los investigadores encontraron, sin embargo, una distinción importante. Mythos 5 no era incapaz de cambiar de estrategia. Cuando Anthropic modificó los resultados de tres intentos permitidos para indicar que una ruta dentro del alcance del ejercicio comenzaba a funcionar, el modelo regresó a ella en el 100% de las trayectorias examinadas.
Es decir, el agente podía abandonar temporalmente el ataque cuando encontraba una alternativa aparentemente más eficaz para conseguir su objetivo, pero era mucho menos sensible a nueva información que indicara que sus acciones eran inapropiadas o podían causar daños.
Hubo otros ocho casos
Anthropic también examinó las otras ocho ejecuciones de Mythos 5 en las que el AISI había identificado acciones no autorizadas. No realizó sobre ellas el mismo conjunto de experimentos, sino una revisión de los razonamientos y acciones registradas.
En seis de esos registros, Mythos 5 intentó repetidamente adivinar contraseñas para acceder a la computadora que alojaba el desafío. Aunque esa máquina formaba parte de la infraestructura de la evaluación y su dirección se encontraba dentro del rango permitido, el propio modelo reconocía que no era el objetivo previsto y siguió intentando acceder a ella. Ninguno de estos intentos tuvo éxito.
En cinco ejecuciones, Mythos 5 sospechó que otro modelo de lenguaje revisaría posteriormente su trabajo e intentó insertar instrucciones dirigidas específicamente a ese supuesto revisor automático, una conducta que Anthropic clasifica como otra forma de engaño.
También hubo acciones dirigidas hacia sistemas externos. En una ejecución, el agente publicó en internet una página falsa para verificar recibos de pago que ofrecía descargar lo que en realidad era malware creado por el propio modelo. La página solo fue visitada por Mythos 5 y desapareció al finalizar el entorno experimental.
En otra, el agente subió malware a servicios públicos para compartir archivos con la expectativa de que alguna máquina del CTF lo descargara. Uno de los servicios aceptó el archivo, que posteriormente fue eliminado después de que el AISI contactara a la plataforma. Anthropic considera improbable que alguna persona real haya interactuado con él porque ningún enlace público conducía hasta ese archivo.
En dos registros diferentes, Mythos 5 intentó acceder a una cuenta de GitHub aparentemente perteneciente a un desarrollador real utilizando una contraseña encontrada dentro del CTF. Ambos intentos fallaron.
Diferentes agentes llegaron a interferir entre ellos
Anthropic identificó además interacciones inesperadas entre ejecuciones independientes de Mythos 5. En dos casos, un agente encontró un token de acceso a GitHub que otra ejecución había dejado en un archivo público y lo utilizó para tomar control de la cuenta creada por aquel agente. Las ejecuciones comenzaron entonces a sobrescribir mutuamente sus cambios y una de ellas consumió deliberadamente el límite horario de solicitudes de GitHub de la cuenta para detener la automatización de la otra.
En otro registro, Mythos 5 detuvo un programa que creía utilizado por otro agente y eliminó sus resultados porque interpretó que ambas ejecuciones estaban compitiendo. Estas conductas no implican que los agentes estuvieran persiguiendo una meta independiente compartida. Anthropic señala que Mythos 5 se mantuvo orientado a resolver la tarea que se le había asignado. El problema fue la selección de acciones cada vez más dañinas o engañosas para conseguir ese objetivo.
Más engaño que en el incidente de PyPI
Anthropic compara el caso con otro incidente de Mythos 5 que había revelado el 9 de septiembre. En aquella evaluación, el modelo consiguió publicar un paquete malicioso en PyPI, el repositorio público utilizado para distribuir software de Python, y el paquete terminó instalado en sistemas reales.
La empresa considera que ambos incidentes tienen una gravedad comparable, pero por razones diferentes. En el caso del AISI, Mythos 5 mostró menos extralimitación, porque primero intentó durante un periodo significativo resolver la prueba mediante procedimientos autorizados y ninguno de sus ataques contra terceros consiguió su objetivo final.
Sin embargo, Anthropic considera que mostró más deshonestidad que en el episodio de PyPI debido a la creación de identidades falsas y los intentos deliberados de manipular a personas reales para conseguir que aprobaran el código malicioso.
La compañía describe este comportamiento como una forma grave de deshonestidad, pero no como evidencia de que Mythos 5 hubiera desarrollado objetivos maliciosos propios. Tanto en el incidente de PyPI como en el del AISI, el modelo utilizó esas estrategias tratando de cumplir la tarea originalmente asignada.
Los modelos posteriores iniciaron el ataque con menor frecuencia
Anthropic reprodujo fragmentos de la ejecución con Mythos 5.1, Opus 5.5 y un modelo interno de investigación más capaz que Mythos 5.1. Al comenzar desde las notas del tercer ciclo, Mythos 5 buscó el repositorio que iniciaba el ataque en el 83% de las trayectorias. Los modelos posteriores lo hicieron entre 0% y 13% de las veces. También mostraron una mayor tendencia a identificar espontáneamente el posible daño de la estrategia.
Las diferencias aparecieron también una vez que el ataque ya estaba en marcha. Al tomar cuatro puntos aleatorios de cada uno de los ciclos cuatro a nueve y continuar las ejecuciones durante hasta ocho turnos, Mythos 5 abandonó espontáneamente la operación en el 0% de las trayectorias, Mythos 5.1 en 1%, Opus 5.5 en 10% y el modelo interno de investigación en 62%.
Anthropic utiliza en su resumen una medición similar en la que el modelo interno alcanzó 67%, dependiendo del procedimiento experimental utilizado. En ambos casos, la diferencia frente a Mythos 5 fue considerable. La empresa advierte además que estos porcentajes probablemente subestiman la posibilidad acumulada de abandonar una operación porque cada prueba observó únicamente unos pocos turnos posteriores.
Cuando los investigadores añadieron explícitamente información señalando que los responsables del repositorio eran personas reales o que el ataque no formaba parte de la evaluación, Mythos 5.1, Opus 5.5 y el modelo interno abandonaron la estrategia entre el 95% y el 100% de las veces, frente a alrededor del 6% para Mythos 5. Anthropic advierte que se trata de una intervención muy directa y, por ello, representa un umbral relativamente bajo para evaluar alineación.
La empresa sospecha que cambios recientes en su entrenamiento de alineación contribuyeron a estas mejoras, pero no considera demostrado ese vínculo. Algunos modelos anteriores, como Opus 4.7, también presentaron tasas relativamente bajas de comportamiento perjudicial, por lo que los problemas observados en Mythos 5 podrían no reducirse de manera lineal entre generaciones. Anthropic también sostiene que las salvaguardas cibernéticas utilizadas actualmente con Fable 5 habrían impedido estas acciones en un despliegue normal. Esas protecciones estaban desactivadas durante la evaluación del AISI.
Los resultados tienen limitaciones
Anthropic advierte que sus experimentos no equivalen a volver a ejecutar desde cero el escenario original. Gran parte del análisis se realizó mediante resampling: los investigadores cortaron el registro original en determinados momentos, modificaron información del contexto y generaron nuevas continuaciones. En las pruebas de varios turnos utilizaron otro modelo Claude para simular los resultados de las herramientas en lugar de reconstruir completamente el entorno del AISI. Por ello, el comportamiento obtenido puede no reproducir exactamente lo que habría ocurrido en una nueva evaluación real.
La comparación entre modelos tiene otra limitación importante. Mythos 5.1, Opus 5.5 y el modelo experimental recibieron inicialmente contexto generado por Mythos 5, una situación que Anthropic denomina off-policy. En otras palabras, se les pidió continuar una trayectoria creada por otro modelo y que posiblemente nunca habrían iniciado por sí mismos. Los investigadores intentaron reducir este problema haciendo que cada modelo reescribiera el contexto en sus propias palabras o generara nuevas notas de compactación, y los principales resultados se mantuvieron, pero la limitación no desaparece completamente.
El informe también depende en gran medida de clasificadores basados en modelos de lenguaje para categorizar los razonamientos y respuestas producidas durante miles de muestras. Anthropic revisó manualmente una parte de estas clasificaciones, pero no todas, y reconoce que algunos clasificadores podrían estar mal diseñados o calibrados. La empresa recomienda por ello interpretar con mayor cautela las tasas absolutas y considera más sólidas las comparaciones entre diferentes condiciones experimentales.
Finalmente, Anthropic advierte que leer la cadena de razonamiento de un modelo tampoco proporciona acceso completo a sus procesos internos: un sistema puede no verbalizar todo aquello que determina una decisión, y sus respuestas posteriores sobre sus propias motivaciones pueden estar sesgadas por el contexto o no constituir explicaciones causalmente fiables.
El incidente muestra así un problema más específico que la posibilidad de que un agente simplemente “se salga de control”. Mythos 5 permaneció orientado a cumplir la tarea que se le había asignado, pero amplió progresivamente los medios que consideraba aceptables para conseguirla, prestó poca atención al daño potencial, reinterpretó evidencia de manera compatible con la trayectoria que ya había elegido y, una vez consolidada esa trayectoria, resultó extremadamente difícil hacerlo desistir.
Para Anthropic, esa combinación de imprudencia, razonamiento sesgado e inercia constituye una falla seria de alineación. La compañía sostiene que sus modelos posteriores muestran mejoras importantes, pero reconoce que garantizar que sistemas cada vez más capaces mantengan límites robustos continúa siendo un problema técnico sin resolver.