Anthropic anunció el lanzamiento de Claude Opus 5, el nuevo modelo de su línea Opus, que la empresa describe como un salto de rendimiento respecto a su predecesor, Opus 4.8, manteniendo el mismo precio: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida.
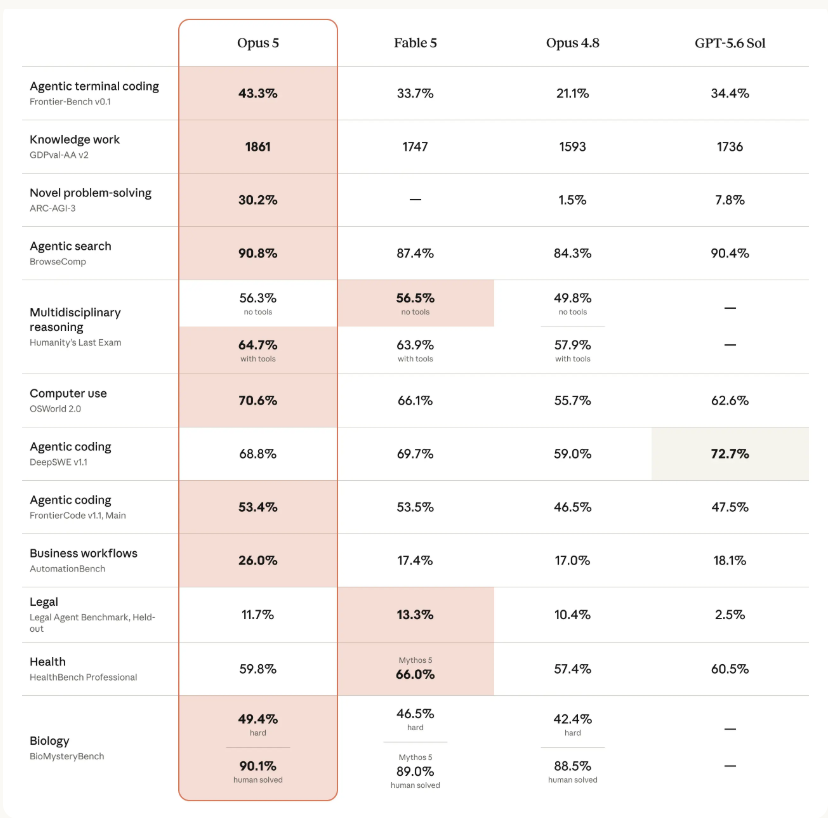
Según Anthropic, Opus 5 se acerca al nivel de inteligencia de Fable 5 a la mitad del costo. La compañía reporta que el modelo lidera evaluaciones de codificación y trabajo de conocimiento como Frontier-Bench v0.1 y GDPval-AA, aunque permanece por detrás de Mythos 5 en tareas de ciberseguridad. En Frontier-Bench, Anthropic afirma que Opus 5 más que duplica el desempeño de Opus 4.8 con un costo menor por tarea. En ARC-AGI 3, la puntuación de Opus 5 triplicaría a la del siguiente mejor modelo.
La empresa también reporta mejoras en investigación científica: en evaluaciones internas de química orgánica, como inferir estructuras moleculares a partir de datos de espectroscopía, Opus 5 obtiene 10.2 puntos porcentuales más que Opus 4.8.
Alineación y seguridad
Anthropic afirma que, en sus auditorías de comportamiento automatizadas previas al despliegue, Opus 5 resultó ser su modelo más alineado hasta ahora, con las tasas más bajas de comportamiento engañoso entre sus modelos actuales. La compañía sostiene que Opus 5 no amplía la frontera en capacidades de doble uso: en pruebas conjuntas con socios del sector privado y gobierno, el modelo se mantuvo por debajo de Mythos 5 tanto en investigación biológica como en ciberseguridad ofensiva, particularmente en la explotación de vulnerabilidades ya identificadas.
Disponibilidad
Opus 5 es ahora el modelo predeterminado en Claude Max y el más potente disponible en Claude Pro. Anthropic también introdujo en beta dos funciones para la Claude Platform: cambios de herramientas a mitad de conversación sin invalidar el caché de prompts, y «fallbacks» automáticos que permiten enrutar solicitudes bloqueadas por los clasificadores de seguridad hacia otro modelo disponible.