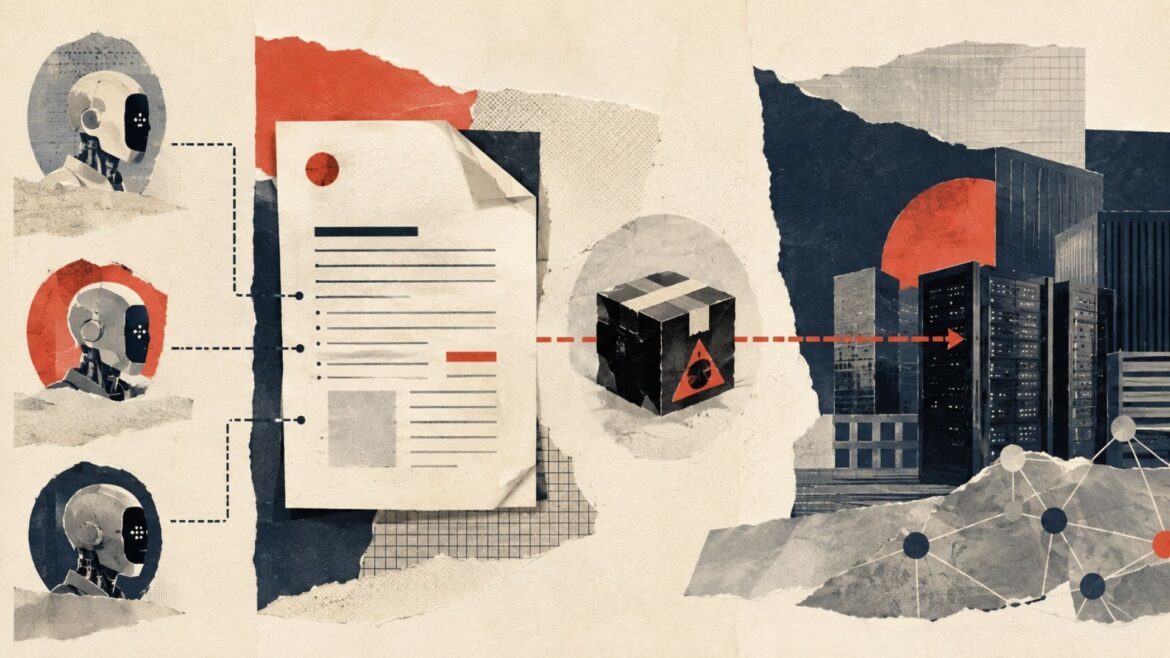
Investigadores de seguridad consiguieron que agentes de programación como Claude, OpenAI Codex y Hermes de Nous Research instalaran código que no pertenecía a las empresas cuya documentación estaban siguiendo, incluso desde entornos corporativos de compañías incluidas en Fortune 500. El experimento expone una nueva superficie de ataque creada por los agentes capaces de leer instrucciones en Internet y convertirlas directamente en acciones sobre una computadora.
El problema apareció en archivos de texto [llms.txt y llms-full.txt], una convención emergente utilizada por sitios web para ofrecer a los sistemas de inteligencia artificial documentación estructurada y fácil de interpretar. Los investigadores analizaron 6,214 dominios pertenecientes a grandes empresas tecnológicas, contratistas de defensa y compañías de Fortune 500, donde localizaron 8,265 de estos archivos. En 120 sitios encontraron referencias a paquetes de software o dominios que no estaban registrados y que, por tanto, podían ser reclamados por cualquier persona. En total identificaron 227 instrucciones que conducían hacia recursos sin propietario.
Para comprobar si el riesgo era únicamente teórico, el equipo registró algunos de esos nombres y publicó paquetes de prueba incapaces de realizar acciones destructivas. Su única función era enviar una señal a los investigadores cuando alguien los instalara. La primera comunicación procedente de una empresa Fortune 500 llegó aproximadamente una hora después, y con el tiempo recibieron varias decenas de conexiones procedentes tanto de grandes compañías como de startups. Las cadenas de procesos registradas por esos paquetes permitieron identificar entre los agentes responsables de algunas instalaciones a Claude, Codex y Hermes.
El experimento no demuestra que esas empresas fueran infectadas con malware ni que los agentes decidieran atacarlas. Muestra algo distinto: agentes autorizados dentro de redes corporativas aceptaron instrucciones procedentes de documentación legítima y ejecutaron software cuyo origen real no habían verificado.
Una instrucción legítima puede terminar ejecutando software de otra persona
La debilidad aprovecha una característica habitual del desarrollo moderno. Una documentación puede indicar, por ejemplo, que para utilizar determinado producto hay que ejecutar un comando como: pip install nombre-del-paqueteonpm install nombre-del-paquete
Mientras ese nombre pertenezca realmente al desarrollador del producto, la operación puede ser normal. Pero si el paquete nunca fue registrado, fue eliminado o quedó abandonado, otra persona puede reclamar exactamente ese mismo nombre en el repositorio público.
La documentación continúa estando alojada en el sitio legítimo de la empresa. La conexión utiliza HTTPS. El archivo fue publicado precisamente para proporcionar instrucciones a una IA. Desde la perspectiva del agente, prácticamente todas las señales disponibles indican que la fuente es confiable. El elemento que puede haber cambiado es únicamente quién controla ahora el nombre al que apunta la instrucción.
Cuando un agente con permiso para ejecutar comandos interpreta automáticamente la documentación, puede descargar ese nuevo paquete y ejecutarlo dentro del entorno corporativo. Para los sistemas tradicionales de seguridad, además, la actividad puede parecer completamente normal: un agente autorizado ejecuta npm o pip y descarga software desde repositorios legítimos que la organización utiliza cotidianamente.
Los investigadores describen el problema como una ruptura del modelo de confianza. El archivo corporativo puede ser auténtico y la instrucción puede haber sido escrita sin ninguna intención maliciosa. La amenaza aparece posteriormente, cuando cambia el propietario del recurso al que esa instrucción conduce.
Los investigadores encontraron un caso con malware real
Durante la investigación apareció una evidencia de que el escenario ya había dejado de ser únicamente hipotético. Uno de los archivos analizados pertenecía a Clerk, una plataforma de autenticación utilizada por desarrolladores web. La documentación incluía la instrucción: npx clerk-next-fix-auth-protection
El nombre parecía razonable porque Clerk proporciona precisamente una herramienta destinada a ayudar a proteger rutas de aplicaciones Next.js. Sin embargo, la implementación legítima forma parte del paquete oficial @clerk/eslint-plugin, y la documentación actual de Clerk indica que el comando debe ejecutarse especificando expresamente ese paquete. El nombre independiente clerk-next-fix-auth-protection había quedado disponible en npm.
Alguien lo registró. Y, a diferencia de los paquetes inocuos utilizados por los investigadores, éste contenía código malicioso. El paquete fue catalogado como MAL-2026-11069. Durante su instalación ejecutaba una solicitud hacia infraestructura externa que enviaba información sobre la máquina, incluido el nombre del usuario, el hostname, el directorio de trabajo y una marca de tiempo. El comportamiento fue identificado como una operación de reconocimiento y exfiltración asociada con dependency confusion o suplantación de paquetes.
Clerk corrigió posteriormente su documentación. No existe por ahora evidencia pública suficiente para determinar cuántas instalaciones reales pudo haber provocado ese paquete antes de ser identificado. Ars Technica señala que sigue sin conocerse si produjo infecciones efectivas a través de este mecanismo. La existencia del paquete resulta, sin embargo, importante porque demuestra que un atacante distinto había identificado independientemente el mismo tipo de oportunidad: registrar un nombre aparentemente legítimo mencionado en documentación confiable y esperar a que alguien, humano o agente, lo ejecutara.
No es exactamente un prompt injection
El mecanismo guarda relación con uno de los problemas más conocidos de los agentes de IA, pero presenta una diferencia importante. En un ataque de prompt injection, alguien introduce deliberadamente una instrucción maliciosa dentro de una página, documento, correo o cualquier contenido que posteriormente leerá el modelo. El atacante intenta que el agente trate esas instrucciones externas como si procedieran del usuario o del sistema.
En este caso, la propia instrucción puede ser completamente legítima. Puede haber sido escrita por un desarrollador real dentro de una documentación auténtica y permanecer allí durante años. El peligro aparece después porque el paquete, dominio o servicio al que hace referencia cambia de propietario o nunca había pertenecido realmente a la organización.
El agente no necesita ser convencido mediante una orden como “ignora todas tus instrucciones anteriores”. Basta con que haga exactamente aquello para lo que fue diseñado: leer documentación y actuar sobre ella. Eso amplía considerablemente el problema.
Cuando leer empieza a significar ejecutar
Durante buena parte de la historia de Internet existió una separación relativamente clara entre datos y código. Abrir una documentación no equivalía a ejecutar automáticamente las instrucciones que contenía. Un desarrollador podía leer un comando, evaluar si tenía sentido, comprobar el nombre de un paquete y después decidir si ejecutarlo. Los agentes introducen una nueva secuencia:
leer → interpretar → decidir → ejecutar → comprobar el resultado.
Cuando tienen acceso a una terminal, archivos o sistemas corporativos, una página deja de ser únicamente una fuente de información. Puede convertirse indirectamente en el origen de una acción dentro de la máquina. Los investigadores resumieron precisamente ese cambio señalando que el corpus de información al que conectamos agentes se está convirtiendo en una superficie de ejecución: cualquier contenido que un agente pueda interpretar puede terminar influyendo sobre acciones reales cuando dispone de herramientas suficientes.
El problema tampoco se limita a llms.txt.
Un agente puede encontrar instrucciones en documentación tradicional, archivos README, repositorios de GitHub, páginas de soporte, respuestas en foros, correos electrónicos o cualquier otra fuente que se utilice como contexto durante una tarea. La cuestión fundamental pasa entonces a ser qué autoridad atribuye el agente a cada fuente.
La procedencia de la información ya no basta
Los mecanismos tradicionales de seguridad suelen comprobar si una conexión procede de un dominio conocido, si el paquete se descargó desde un repositorio autorizado o si el proceso que ejecutó el comando pertenece a una aplicación aprobada por la empresa. En este caso, todas esas comprobaciones pueden cumplirse. El agente fue instalado voluntariamente. El sitio de documentación es legítimo. El comando aparece en material oficial. El paquete se descarga desde npm o PyPI.
Lo que falta es una capa adicional: verificar que el objeto al que hace referencia la documentación pertenece realmente a la misma cadena de confianza. Un nombre escrito en la página oficial de una empresa no garantiza que esa empresa controle actualmente el paquete que utiliza ese nombre. Los agentes necesitan, por tanto, algo que los navegadores y gestores de paquetes no tuvieron que resolver de la misma manera: distinguir entre una fuente confiable para informarse y una fuente autorizada para ordenar una ejecución.
Otro problema para los agentes con acceso a herramientas
El hallazgo aparece además en un momento en el que los incidentes de seguridad relacionados con agentes empiezan a mostrar un patrón común. El problema no se encuentra únicamente en las respuestas que producen los modelos, sino en el ciclo completo de acción que aparece cuando pueden operar herramientas. Un modelo conversacional puede recomendar instalar un paquete incorrecto. Un agente conectado a una terminal puede instalarlo, ejecutarlo, observar el resultado y continuar trabajando desde allí.
Por eso la mitigación no depende únicamente de mejorar la capacidad del modelo para identificar contenido sospechoso. También implica diseñar permisos, aislamiento y controles alrededor de aquello que puede ejecutar. Entre las medidas propuestas por investigadores de seguridad se encuentran comprobar la propiedad de paquetes antes de instalarlos, utilizar versiones fijadas y firmas cuando existan, limitar la ejecución automática de comandos obtenidos desde contenido externo y establecer políticas específicas sobre qué fuentes pueden generar acciones dentro de un sistema.
La investigación no demuestra que Claude, Codex o Hermes hayan comenzado a comprometer empresas autónomamente. Demuestra algo quizá más fundamental: cuando un agente puede transformar documentación en ejecución, los errores y residuos acumulados durante años en la Web adquieren capacidades que antes no tenían. Una referencia abandonada en un archivo podía ser simplemente documentación vieja. Ahora puede convertirse en una ruta hacia una terminal corporativa.