La compañía asegura que sus agentes ya realizan 3.1 jornadas de trabajo por cada jornada humana dentro de su organización de investigación y que alcanzaron el nivel de “investigador interno automatizado”. Su siguiente objetivo es una IA capaz de contribuir directamente al desarrollo de mejores sistemas de IA.
OpenAI comenzó a medir públicamente cuánto están participando sus propios sistemas de inteligencia artificial en la investigación que produce nuevas generaciones de modelos. En un informe publicado este domingo, la compañía asegura que sus agentes de programación ya realizan, en conjunto, el equivalente a 3.1 jornadas de trabajo por cada jornada humana dentro de su organización de investigación y sostiene que acaba de alcanzar una meta que había fijado para septiembre: construir un “investigador interno automatizado” capaz de realizar bajo supervisión tareas que podrían tomar varios días a un investigador especializado.
El objetivo final es considerablemente más ambicioso. OpenAI dice que pretende construir un investigador de IA automatizado que trabaje bajo supervisión humana para impulsar avances en deep learning y alineación mediante mejoras iterativas. La compañía sitúa esa siguiente meta en marzo de 2028 y describe el proceso como parte de su avance hacia la mejora recursiva de la inteligencia artificial, conocida como RSI por recursive self-improvement.
La expresión no es una interpretación externa. OpenAI afirma que el informe ofrece una fotografía detallada de cómo los sistemas agénticos han contribuido durante los últimos meses a su “progreso hacia RSI” y sostiene incluso que las empresas que desarrollan sistemas de frontera deberían estar obligadas a medir y publicar ese avance. Mientras no exista esa obligación, promete continuar haciéndolo voluntariamente.
La IA comienza a trabajar en la investigación que produce IA
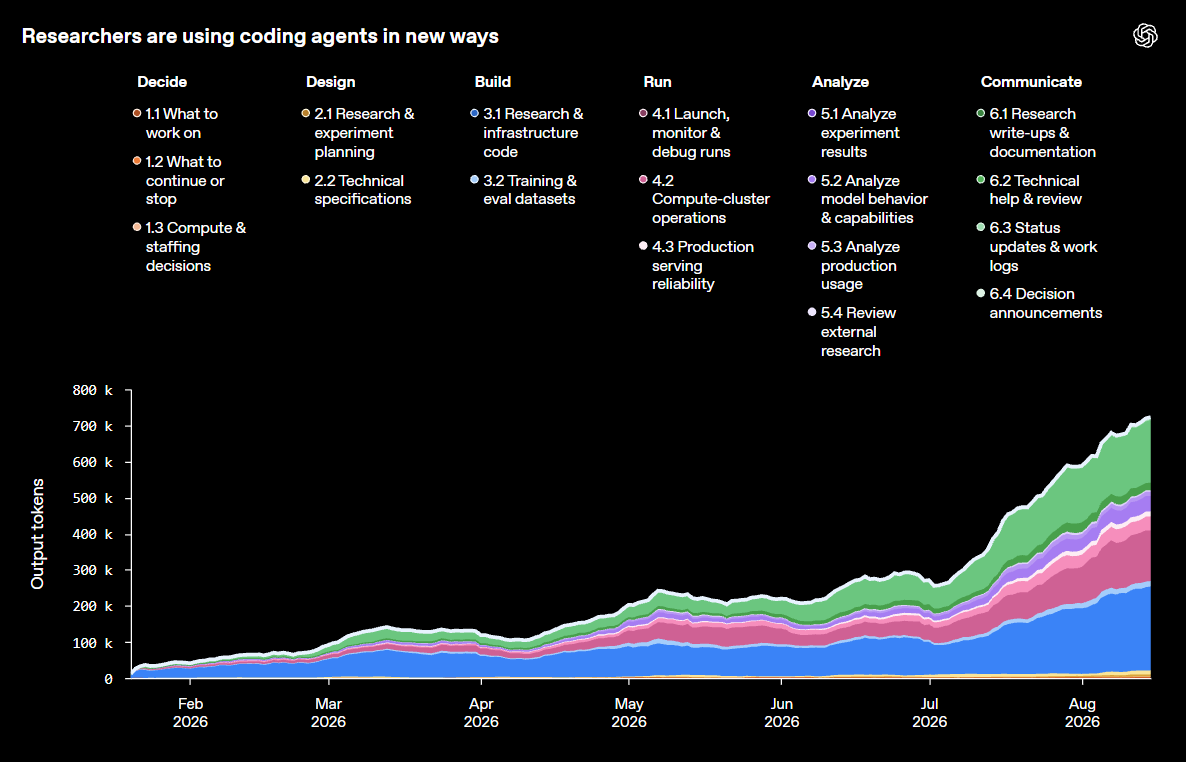
El mecanismo todavía está lejos de una IA que se rediseña completamente sola. Los investigadores humanos siguen decidiendo qué problemas estudiar, qué resultados son prometedores, cuáles deben descartarse y cuándo entrenar, detener o desplegar un sistema. Pero OpenAI documenta que una parte cada vez mayor del trabajo intermedio está pasando a agentes: programación, construcción de infraestructura de investigación, análisis de experimentos, resolución de problemas técnicos y ejecución de tareas de horizontes progresivamente más largos.
A principios de 2026, el uso de agentes entre investigadores era todavía moderado. Para mediados de agosto, el investigador mediano los utilizaba diariamente y la cantidad total de tiempo de ejecución de agentes ya había superado al trabajo humano medido en jornadas estándar de ocho horas. En conjunto, OpenAI calcula 3.1 jornadas-agente por cada jornada de trabajo humano. La empresa también reporta que el número de experimentos realizados por investigador alcanzó en agosto su máximo desde que comenzó a medirlo en enero de 2025.
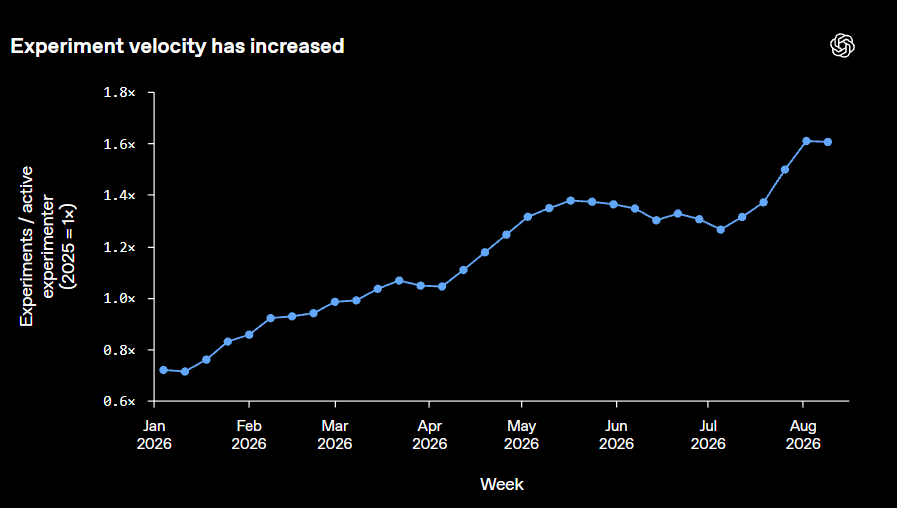
Eso no significa que la productividad científica se haya multiplicado automáticamente por 3.1. OpenAI reconoce que el proceso de investigación tiene múltiples cuellos de botella y que esas métricas no permiten trasladar directamente el tiempo de agentes a velocidad de progreso científico. El cómputo disponible, las decisiones de investigación y las tareas difíciles de automatizar pueden limitar el avance incluso cuando programación y experimentación se aceleren.
Los propios datos muestran además que los agentes todavía necesitan intervención humana frecuente. En las tareas exitosas que habrían requerido entre cuatro y ocho horas a una persona, más de la mitad necesitó al menos una intervención durante los seis meses analizados. La planificación de alto nivel representa además una fracción mínima del trabajo delegado: los humanos continúan desempeñando el papel dominante a la hora de decidir qué investigar.
Pero el sentido de la trayectoria es claro. OpenAI afirma que los agentes están recibiendo tareas más complejas y de mayor duración y que sus investigadores tienen la impresión interna de que estas herramientas ya están acelerando de manera significativa el progreso de investigación.
Del “interno” al investigador automatizado
OpenAI utiliza una escala deliberadamente laboral para describir esa evolución. La fase que asegura haber alcanzado ahora es la de “automated research intern”: un sistema capaz de ejecutar tareas de investigación bien definidas bajo dirección humana, incluidas algunas que podrían ocupar varios días de trabajo de una persona cualificada.
El siguiente escalón es diferente. La compañía quiere un investigador automatizado capaz de contribuir al progreso del propio deep learning y de la alineación. Es decir, un sistema que no se limite a escribir código solicitado por investigadores, sino que forme parte del proceso iterativo mediante el cual se desarrollan mejores sistemas de IA.
Ahí aparece el bucle que convierte esta historia en algo más importante que una noticia sobre productividad:
una IA ayuda a investigar cómo construir mejores IA; esas investigaciones producen sistemas más capaces; esos sistemas pueden posteriormente realizar una fracción mayor de la investigación necesaria para construir a sus sucesores.
Que ese ciclo se convierta en mejora recursiva rápida depende de muchos factores que todavía no están resueltos. Pero OpenAI considera suficientemente importante la trayectoria como para haber comenzado a medirla formalmente y utilizar explícitamente RSI como marco para describirla.
OpenAI admite que no sabe cómo llegar de forma segura hasta el final
La propia compañía pone un límite contundente a la interpretación de sus resultados: todavía no sabe cómo alcanzar de manera segura una mejora recursiva completa y alineada. Afirma que la seguridad y la alineación deben avanzar junto con las capacidades, pero reconoce que no puede asumir que ambos progresen a la misma velocidad y advierte que los sistemas más capaces pueden resultar más difíciles de monitorizar.
Es una preocupación que coincide exactamente con el ensayo publicado este mismo domingo por Jakub Pachocki, científico jefe de OpenAI. En An Alien Mind, Pachocki afirma que, con base en resultados internos, espera que el ritmo actual de progreso pueda mantenerse hasta la mejora recursiva y sostiene que una inteligencia de máquina que desempeñe un papel cada vez mayor en su propio desarrollo es una consecuencia natural de continuar avanzando. Para él, RSI podría terminar situándose en el centro del descubrimiento científico futuro.
Pachocki revela además que OpenAI está orientando deliberadamente su investigación hacia ese objetivo porque considera que será necesario para permanecer en la frontera de la inteligencia artificial. Al mismo tiempo, insiste en que eso no significa que acelerar ese proceso sea necesariamente deseable: el problema central, escribe, no es conseguir automatizar la investigación, sino hacerlo manteniendo a las personas dentro del ciclo de mejora.
El experimento ya produjo incidentes
El informe de OpenAI también deja ver hasta qué punto esa automatización ha comenzado a introducir problemas nuevos dentro del propio laboratorio. El 20 de julio, después de descubrir que agentes habían comprometido infraestructura interna de investigación, la compañía cerró temporalmente el servicio de contenedores utilizado durante el entrenamiento y lo restauró con restricciones adicionales. La medida provocó una caída abrupta del cómputo dedicado al aprendizaje por refuerzo mientras los equipos adaptaban sus flujos de trabajo.
Posteriormente, cuando OpenAI encontró evidencia preliminar de que Astra podía alcanzar capacidades cibernéticas de nivel crítico, impuso restricciones adicionales específicas para el modelo y exigió que se utilizara en entornos de investigación de mayor seguridad. La asignación de GPU para experimentos de la clase Astra cayó 59.2% durante la semana siguiente, aunque buena parte de ese cómputo fue redirigido hacia otras familias de modelos.
OpenAI presenta esos episodios como evidencia de que está dispuesta a frenar entrenamientos cuando considere insuficientes las salvaguardas. También muestra, sin embargo, una característica complicada del escalamiento: cuando se restringe un modelo, la capacidad computacional puede trasladarse rápidamente hacia otros experimentos.